
AI組織への道②事後学習で自社に特化したAIを作る


AIモデルは既に十分賢い。足りないのは、それを活かす企業側の体制だと言われる。前回紹介した常駐型エンジニアのAI導入部隊は、この体制側を整備するビジネスである。これに対し、逆の発想で勝負を仕掛けるのが、OpenAIの元CTO、Mira Murati氏が立ち上げた米Thinking Machines Labだ。企業がモデルに合わせるのではなく、モデルを自社業務に合わせて事後学習で作り替える。同社の学習基盤を使った世界最大級のヘッジファンド、米Bridgewater Associatesの実験結果が6月30日に公開され、この手法の威力が数字で示された。
プロには一瞬で分かる、AIは五割止まり
Thinking Machinesの学習基盤を使ってBridgewaterが行った実験の対象は、投資判断そのものではない。その手前にある、書類の仕分けである。
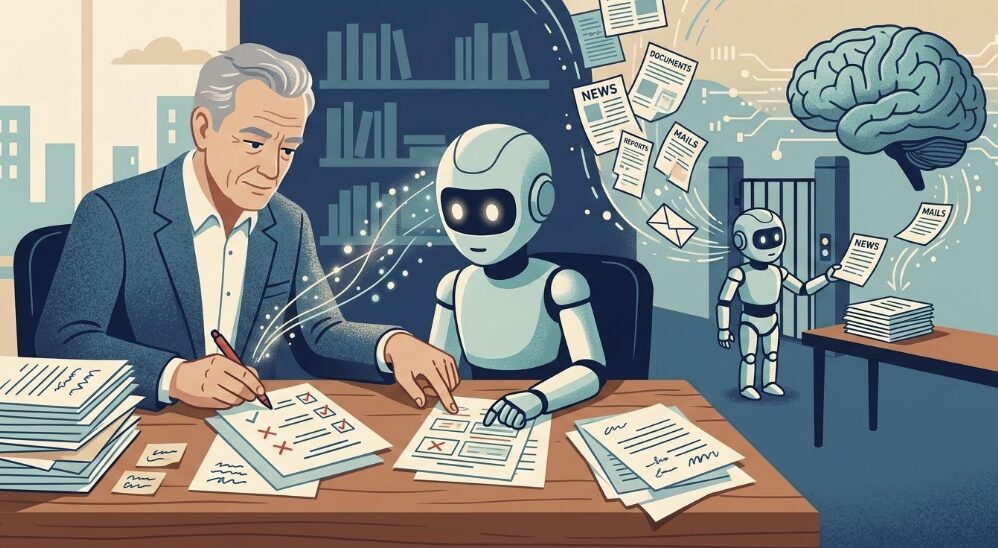
投資家のもとには毎日、ニュース記事、調査レポート、中央銀行の文書、メール、社内メモが押し寄せる。読むこと自体は簡単で、本当の仕事はどれを読むべきかの選別にある。同社はこの選別を6つのタスクに分解した。金融記事が経営層級の投資家に関連するかの分類。中央銀行の文書が今後の金利変更の方向を示唆しているかの判定。調査文書が投資家の問いに答えているかの評価。文書やメールのどこからが定型文かの特定、などである。
ベテラン投資家なら一瞬で判断できる作業だ。ところが世界最高のフロンティアモデル群に、タスクの内容をそのまま伝えるプロンプトで解かせると、正答率は平均45〜50%だった。二択の問題で五割なら、当てずっぽうと変わらない。
論文には具体例がある。Trump大統領によるGreenland領有の主張を伝える記事と、Trump政権の対中関税の威嚇でS&P500が急落したという記事。どちらも地政学と金融にまたがる話題だが、マクロ投資家にとって前者は「無関係」、後者は「関連あり」である。プロなら考えるまでもなく区別できる。AIにはできない。
そこで同社の投資のプロたちがプロンプトの改良に乗り出した。実際の業務定義に基づいて指示を書き直し、問いの立て方も変えた。たとえば記事の分類を「関連あり/なし」の二択から、「関連があり興味深い/関連はあるが興味を引かない/無関係」の三分類に変更。小規模な新規上場の記事は財務的には明らかに関連するが、マクロ投資家が読む価値はない、という機微を問いの構造に埋め込んだ。
この工夫で正答率は70%台まで上がった。だが、そこで止まった。プロンプトを機械的に改良し続ける自動最適化の手法を投入しても、それ以上は伸びなかったという。Claude Opus 4.8やGPT-5.5といった最新モデルを使っても、最高で78.2%。同社が「日常業務で信頼して使える水準」として置いた80%に、どのモデルも届かなかった。
モデルの世代交代を待つ手も、あてにならない。論文は「GPT 5.4は5.2より43%高価だが、精度の向上はわずか」と指摘する。
なぜ止まるのか。論文の説明は明快である。プロンプトは、専門家が言葉にできた分の直感しか運べない。そして最も重要な判断ほど、言葉にするのが最も難しい。
ベテランが新人に「関税の見出しは今の相場環境なら必読、派手な地政学ニュースは雑音」と教えることはできる。だが、その線引きを何百通りの状況すべてについて文章に書き尽くすことはできない。書き尽くせない部分こそが、その道のプロの価値だからだ。それが暗黙知と呼ばれてきたものの正体だ。プロンプトという手段は、この壁の手前までしか行けない。
教本で教えず、添削で写す
壁を破った方法が事後学習である。プロンプトで判断基準を説明するのをやめ、プロが判断した実例を大量に見せて、モデル自体を訓練し直した。
ただし、その道のりは単純ではなかった。論文が正直に記しているのは、最大の障壁が計算資源ではなく、教材の質だったことである。
訓練には、正解ラベル付きのデータがいる。同社は当初、このラベル付けを外部業者に委託した。ところが、そのデータで訓練したモデルは使いものにならなかった。原因を調べると、モデルではなくラベルが間違っていた。金融の専門家でない作業者には、そもそも正解が分からなかったのである。プロの判断を写すには、プロ自身が教材を作るしかない。だがプロの時間は高くつき、何万件ものラベル付けを頼むわけにはいかない。
そこで同社は、業者製の教材の中から間違いの疑いが濃い箇所だけをあぶり出し、そこにプロを投入することにした。使ったのは、いったん業者のラベルで訓練した仮のモデルである。このモデルに、今度は試験官役として同じデータを判定させ、モデルの答えが業者のラベルと食い違った例だけを抜き出した。訓練で散々見せられたはずのデータと違う答えを出すなら、その問題が本当に難しいか、ラベルの側が間違っているかのどちらかだからである。こうして絞り込んだ争点だけを社内の投資のプロに回し、判定し直させた。プロの時間という最も希少な資源を、全件ではなく急所にだけ注ぎ込む仕組みである。
訓練の土台には、中国Alibaba製のオープンモデルQwen3-235Bを選んだ。ファインチューニングの特性が学術研究で最もよく調べられているモデルだからだという。素のQwenの正答率は44.8%と、当てずっぽうの水準である。ここから出発し、プロのラベルを使った標準的な強化学習で73.5%まで引き上げた。それでも目標の80%には届かない。
最後の伸びをもたらした工夫のひとつが、on-policy蒸留と呼ばれる事後学習の手法である。蒸留とは、賢いが運用の高くつく「教師モデル」の判断力を、小さく安い「生徒モデル」に移す手法を指す。従来のやり方では、教師が出した模範解答を集め、生徒に真似させていた。on-policy蒸留は順序が逆になる。まず生徒自身に問題を解かせ、その答案を教師が採点・添削する。生徒は自分が実際に犯した間違いを直されるので、模範解答を眺めるだけより、はるかに効率よく学ぶ。人間の学習と同じである。実験ではさらに、検証テストの成績が最高値を更新したときだけ教師を最新のモデルに入れ替える仕組みを組み、弱い教師から学んでしまう事態を防いだ。訓練データの並べ方や損失関数の選択も含め、複数の工夫を積み上げた結果が、正答率84.7%である。
得られたモデルの利点は精度だけではない。1000タスクあたりの処理費用は約7.25ドル。フロンティアモデル最高値の約100ドルに対し、14分の1近い。もっともこの差の大部分は、モデル自体が小さいことによる。判断基準を体得した専門特化のモデルは、巨大な汎用モデルの知識を持ち歩く必要がないのである。
なお、論文で公開されたのは6タスクの結果だが、同社の社内には同種のタスクが他にも多数あり、そこでも自社訓練モデルがフロンティアモデルを上回る同じ傾向を確認しているという。その上で論文は、今後は業務ごとに訓練したモデルをさらに増やしていく計画だと明かしている。だからこそ運用コストが重要な考慮事項になる、と。自社特化モデルは一体作って終わりではなく、量産する。それがこの実験から見えるBridgewaterの構想である。
自社の業務は、どちら側か
ただし、事後学習が今すぐ誰にでもできるわけではない。実験を行ったのはBridgewater社内のAIA Labsという研究部門で、投資のプロと機械学習の研究者を同じ屋根の下に抱える例外的な組織である。論文を書いたのも同部門の5人で、Thinking Machinesは学習基盤の提供側として関わった。84.7%という数字も両社自身の評価であり、公表されている企業事例は現時点でこの一社だけだ。
外注で済まない工程があることも、この実験は示した。外部業者のラベルで訓練したモデルは使いものにならず、争点はプロ自身が判定し直すしかなかった。少なくともこの実験は、プロが自らの時間を割いて判断を教材にすることなしには、成立しなかったのである。
それでも、この実験が企業に突きつける問いは明確である。専門部隊を持たない企業でも事後学習を可能にするサービスやツールは登場し始めており、敷居は今後下がっていくだろう。エージェントに業務の文脈や判断基準を与える仕組み(ハーネス)を工夫する体制整備の側でも、暗黙知の一部を取り込めるようになるかもしれない。だが現時点で多くの企業が考えるべきことは、自社のどの業務が体制整備の上でのプロンプトで足りて、どの業務が事後学習まで必要になるのか、という見極めである。
分かれ目の目安は、正解の性質にある。問い合わせ対応や文書検索のように、正解が明文化されており、専門家でなくても正誤を判定できる業務は、体制整備した上でのプロンプトで足りる。一方、与信の判断、品質の目利き、案件の筋の見極めのように、正解がベテランの頭の中にしかない業務は、プロンプトをいくら磨いても、いずれ壁に当たる。それが、その会社の競争力の源泉である暗黙知を含む場合が多い。この暗黙知をハーネスを含む体制整備でシステムに取り込めるのか、それとも事後学習が必要になるのか。ここが今後の技術革新の注目点の一つになる。
事後学習を選んだ業務でも、汎用モデルが不要になるわけではない。Bridgewater自身、事後学習で訓練した小型の専用モデルに文書の仕分けという門番役を任せ、選び抜かれた文書の深い分析は汎用のフロンティアモデルに委ねる分業を敷いている。専用モデルが門番、汎用モデルが参謀という使い分けである。
つまり、AI組織への道に一本の正解はない。体制整備で足りる業務と事後学習まで要る業務を見極め、専用モデルと汎用モデルを業務の性質に応じて組み合わせる。自社の業務のどこに暗黙知が宿っているかを知る企業ほど、この見極めは速く、的確になる。AIの導入とは結局、自社の仕事を解像度高く理解し直す作業なのである。
