プロンプトエンジニアリングとは?ChatGPT・Claude・Geminiの使い分けと2026年の実務ポイントを解説


生成AIへの指示文をプロンプト、その設計・最適化をプロンプトエンジニアリングと呼びます。
同じモデルでも、指示の組み立て方によって出力の品質と再現性は大きく変わります。法人利用では、この「再現性」と「組織での標準化」が成果を左右します。
2026年現在、生成AIは「うまく指示を書く」段階から、推論(Thinking)モデルやAIエージェントを前提に「AIに渡す情報環境を設計する」段階へと移りつつあります。
本記事では、海外の実証研究や各社の公式ドキュメントを踏まえ、2026年時点でプロンプトエンジニアリングがどこまで有効か、ツールごとに何を変えるべきか、業務での具体的な活用までを、法人の実務担当者向けに整理します。
プロンプトエンジニアリングとは
プロンプトエンジニアリングは、プロンプトを設計し、AIから望ましい出力を安定して引き出すための技術です。
専用言語ではなく自然言語で指示を組み立てるため誰でも着手できますが、伝え方の精度によって成果の再現性は大きく変わります。
LLM(生成AIの基盤となる大規模言語モデル)には、与えられる情報の質や量が十分でないと出力が安定しにくい傾向があります。裏を返せば、何を・どんな前提で・どの形式で求めるかさえ明確に示せば、出力は安定しやすくなります。法人では、次の3点が導入効果に直結します。
- 生産性:調べもの・資料作成・要約などの所要時間を短縮する
- 品質の安定:指示の型をそろえ、担当者によらず一定の出力を得る
- 組織展開:テンプレートを社内共有し、特定の人に依存せず全社で活用する
ChatGPT・Claude・Geminiは基本が共通でも最適解が異なる
代表的な生成AIには、OpenAIのChatGPT(GPT系)、AnthropicのClaude、GoogleのGeminiがあります。いずれもLLMを基盤とし、プロンプトの基本的な考え方は共通です。
一方で2026年時点では各社とも、回答前に内部で段階的に推論する推論(Thinking)モデルを標準的に提供しており、モデルによって最適な書き方は異なります。
具体的なモデル世代は更新が速いため、利用時には最新版とAPI仕様を確認しておきたいところです。詳しい使い分けは「ChatGPT・Claude・Gemini別に見るプロンプト最適化の要点」の章で解説します。
法人での選び方は関連記事の法人向け生成AIサービス、Geminiの法人利用はGemini 法人もご参照ください。
国内利用データが示すプロンプト習得の必要性
プロンプトを扱うスキルがどれほど求められているかは、国内の利用データからも確認できます。総務省「令和7年版 情報通信白書」によると、生成AIを使った経験のある個人は日本で26.7%。前年の9.1%から約3倍に増えました。
ただし国際比較では差が大きく、個人の利用経験は米国68.8%・中国81.2%・ドイツ59.2%。企業の業務利用率も日本は55.2%で、米国・中国・ドイツはいずれも9割を超えます(下図)。
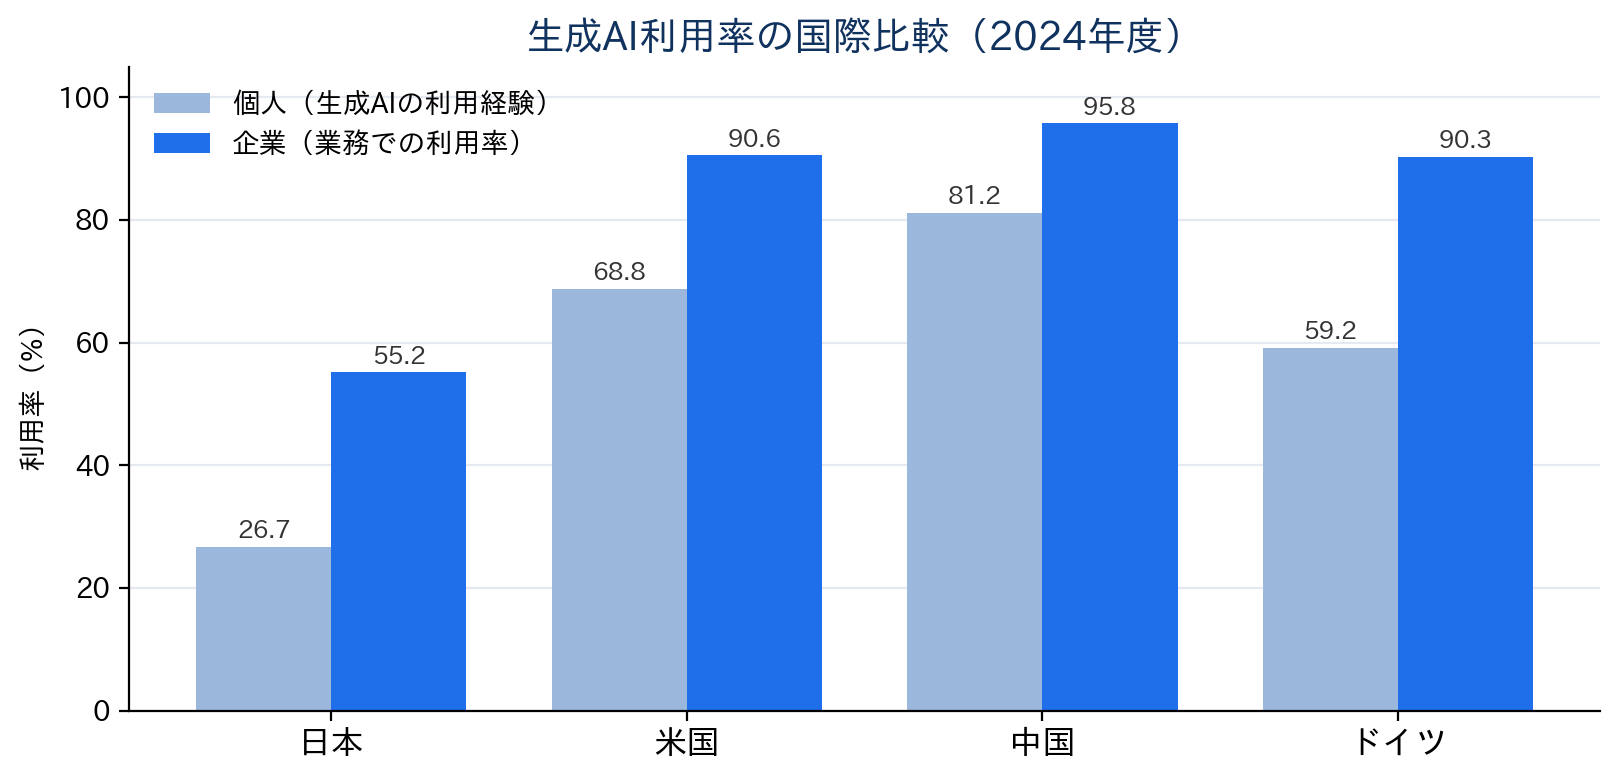
総務省「令和7年版 情報通信白書」(2025)をもとに作成(個人=利用経験、企業=業務での利用率)
使わない理由は「自分の生活や業務に必要ない」に次いで「使い方がわからない」が上位に挙がっています。生成AIの「使い方」とは、突き詰めればAIへの指示の出し方に行き着きます。ツールに触れる機会があっても、指示を設計する力が伴わなければ成果にはつながりにくく、この点が普及のボトルネックになっている実態がうかがえます。
企業の導入も進み、JUAS「企業IT動向調査2026」(速報値)では言語系生成AIを導入済み・準備中とした企業が53.4%(前年度41.2%)。売上高1兆円以上の大企業では8割超がすでに導入済みです。一方で前年度の同調査では、導入企業のうち「期待を大きく超える効果があった」との回答は4.0%にとどまっており、導入がそのまま成果に直結しているわけではありません。導入が広がるほど、現場で使いこなせる人材と標準化された運用の重要度が増しています。
出典:
総務省「令和7年版 情報通信白書」(2025)
JUAS「企業IT動向調査2026」速報(2026)
JUAS「企業IT動向調査2025」(2025)
【2026年最新】プロンプトエンジニアリングの前提を変えた2つの変化
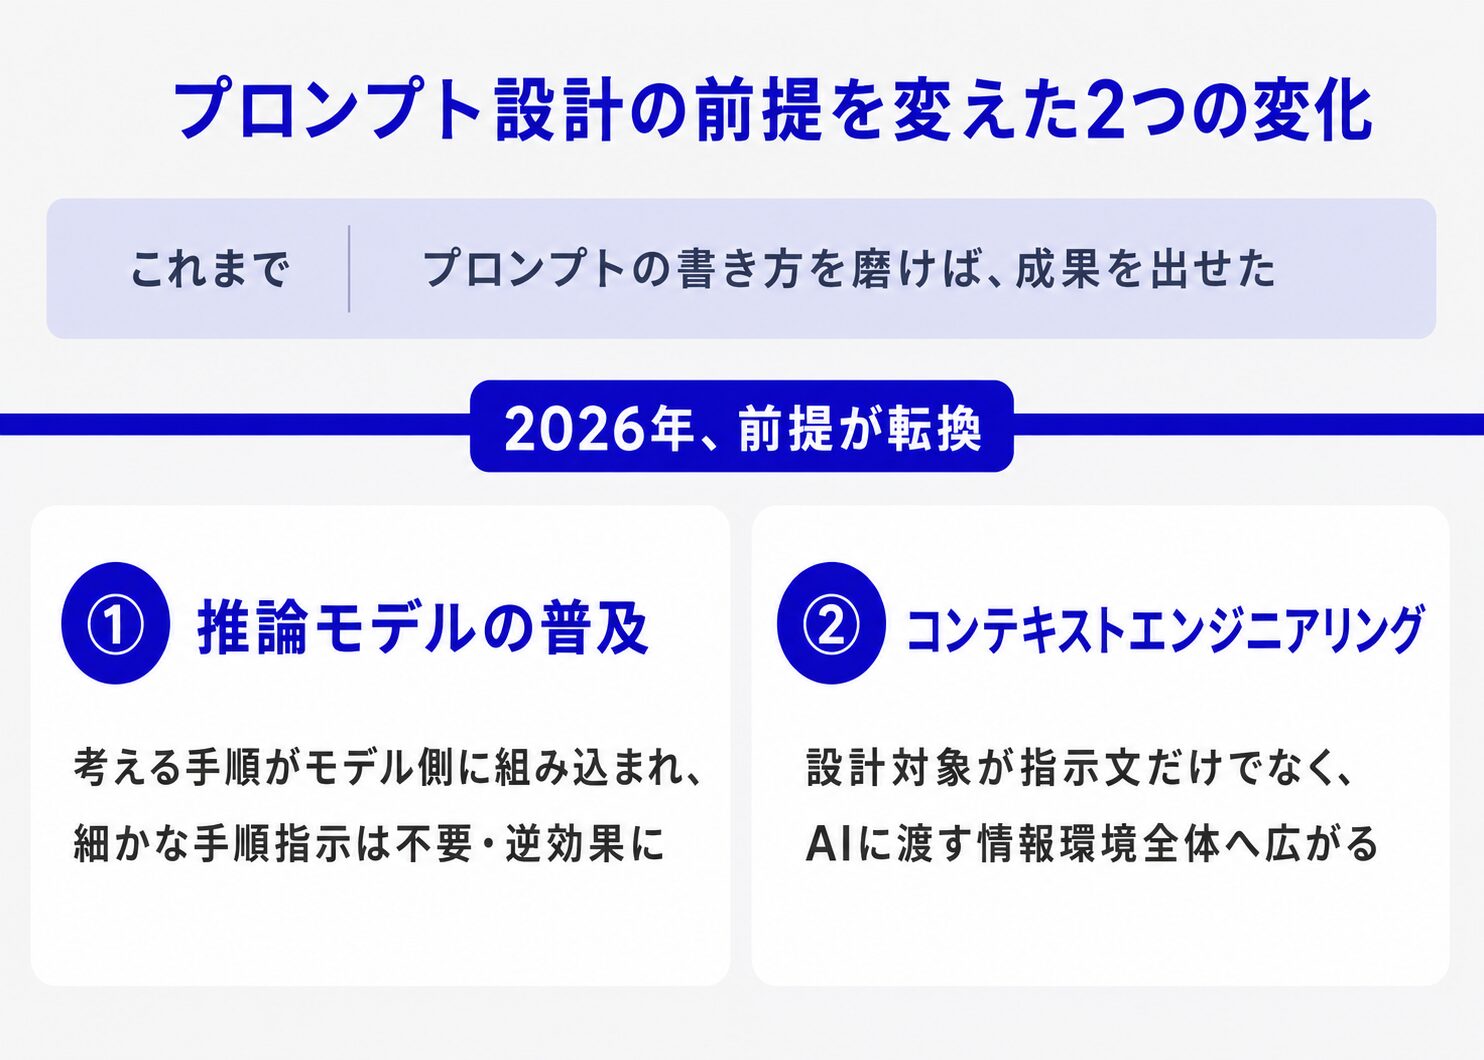
プロンプトを設計する力の重要性は高まる一方ですが、では何を身につければよいのか。その中身が、ここ2年で大きく変わりました。変化は2つ。モデル自身が推論するようになったこと(推論モデル)と、AIに渡す情報環境全体を設計する発想が広がったこと(コンテキストエンジニアリング)です。いずれも2026年のプロンプト設計の前提となるため、基本テクニックの前におさえておきましょう。
推論モデルの普及で変わったプロンプトの書き方
まずは1つ目の推論モデルです。2024年9月のOpenAI o1以降、回答前に内部で段階的に推論してから答える推論(Thinking)モデルが各社の標準ラインナップになりました。
GPT系のThinking、ClaudeのExtended Thinking、GeminiのThinking/Deep Thinkなどが該当します。従来は人間がプロンプトで補っていた「考える手順」が、モデル側に組み込まれた形です。
重要なのは、この変化によって「ステップごとに考えて」と促すCoT(Chain-of-Thought)など、従来の定番テクニックの一部が「不要」または「逆効果」になった点です。
OpenAIの推論モデル向けガイドは、推論モデルを「プランナー」、GPT系の汎用モデルを「ワークホース(実行役)」と位置づけ、推論モデルは情報が限られていたり断片的だったりしても簡潔な指示で意図を汲むため、細かな手順指示は不要だと説明しています。
Googleも最新のGemini開発者向けガイドで、Gemini 3は推論モデルであり、簡潔で明確な指示が最適、旧モデル向けの複雑なプロンプト技法はかえって過剰分析を招くとし、思考過程を細かく指定する必要はないと案内しています。
2026年の実務上の原則は、使うモデルが推論モデルかどうかで書き方を変えることです。両者で何がどう違うのか、具体的に見比べてみましょう。
| 観点 | 推論(Thinking)モデル | 通常モデル |
|---|---|---|
| CoT(手順を促す) | 原則不要または逆効果(応答時間も増える) | 論理タスクでは有効 |
| 渡し方 | 目的・前提・制約・出力形式を簡潔に渡す | 手順を明示し、段階的に促す |
| 思考の制御 | API設定(reasoning_effort等)で深さを調整 | プロンプト本文で誘導する |
| 指示の例 | 「次の契約書のリスクを3点、根拠つきで挙げて」 | 「次の手順で計算して:(1)…(2)…(3)…」 |
要は、推論モデルには目的・前提・制約・出力形式だけを簡潔に渡して考え方そのものは任せる、通常モデルには手順や段階を示して考え方を補う、という使い分けです。同じ依頼内容でもモデルの種類によって最適な指示文は変わるため、まずは自分が使っているモデルがどちらに当たるかの確認から始めるのがよいでしょう。
出典:
OpenAI「Reasoning best practices」
Google「Gemini 3 Developer Guide」
Google「Prompt design strategies」
設計対象はプロンプトからコンテキスト全体へ広がる
2025年以降、議論の中心は「うまく指示を書くこと」から「AIに渡す情報環境をどう設計するか」へ移りました。これが2つ目の変化であるコンテキストエンジニアリングです。
会社でAIエージェントやRAG(社内文書などを検索してAIに参照させる仕組み)を本格的に活用するうえで要となる考え方のため、本章ではまず考え方の要点を整理します。性能が落ちる仕組みや具体策、実務への落とし込みは「コンテキストエンジニアリングを実践する手順とポイント」の章で解説します。
コンテキストエンジニアリングはプロンプト設計の発展形
この考え方を体系的に示しているのが、Claudeを開発するAnthropicの公式レポートです。同社はコンテキストエンジニアリングをプロンプトエンジニアリングの自然な発展形と位置づけています。
モデルが賢くなるほど、課題は「完璧な一文を書くこと」ではなく「各ステップでモデルに何をどこまで読ませるか」を慎重に選ぶことに移るという整理です。
役割でいえば、細かな指示を逐一書き込む「マイクロマネージャー」から、AIの情報環境を整える「キュレーター」への転換です。方針はシンプルで、望む結果につながる情報だけを選び、無駄なく渡すことです。実務では「資料を増やすほど精度が上がる」という前提を見直し、渡す情報を選別する側に回ることが出発点になります。
同様の整理は、LLMアプリ開発フレームワークを提供するLangChainの解説にも見られます。同社はコンテキストウィンドウをモデルの限られた作業メモリ(コンピュータのRAMに近いもの)と捉え、その管理方法を体系化しました。では、プロンプトエンジニアリングとは何が違うのか。両者は対立する概念ではなく、問い・対象・手段がそれぞれ次のように異なります。
| 観点 | プロンプトエンジニアリング | コンテキストエンジニアリング |
|---|---|---|
| 問い | どう尋ねるか(指示の書き方) | 何を見せるか(情報環境の設計) |
| 対象 | 単発の指示文 | 動的に変わる情報環境全体(システム) |
| たとえ | 正しい一文を磨く職人芸 | OSがRAMを管理するように情報を取捨選択 |
| 目標 | 望む出力を引き出す | 必要な情報だけを最小限のトークンで渡す |
| 主な手段 | 型・例示・出力形式の指定 | RAG・メモリ・要約・分離・ツール設計 |
担当者レベルでは、難しく構える必要はありません。たとえば会議メモを丸ごと貼り付けて要約させるのではなく、判断に必要な部分だけを貼り、前提と出力形式を添える。日々のこうした取捨選択が、コンテキストエンジニアリングの第一歩です。
出典:
Anthropic「Effective context engineering for AI agents」(2025)
LangChain「Context Engineering for Agents」(2025)
【海外研究】プロンプトエンジニアリングは今も有効という実証結果
こうした変化を受けて「プロンプトエンジニアリングはもう古い」という見方も出ていますが、実証研究の結論を先に示すと、そうではありません。丁寧な言い回しやペルソナ付与といった文言上の工夫の効果はまちまちである一方、タスク・前提・出力形式を明確に構造化して伝える基本は、今も有効です。
米ペンシルベニア大学ウォートン校のGenerative AI Labsは、各種の通説を統計的に検証した「Prompting Science Report」シリーズを公開しており、結論はおおむね次のとおりです。
- プロンプトの工夫の効果はタスク次第(Report 1):丁寧な依頼や命令口調などの効果は質問ごとにばらつき、全体平均では相殺されやすい。万能の「魔法の呪文」は確認されていない。
- CoTの価値は低下(Report 2):「ステップごとに考えて」は、推論モデルでは精度向上がわずかな一方で応答時間が増加。通常モデルでも平均は小幅改善だが回答のばらつきが増えることがある。
- チップ・脅しの効果は確認されず(Report 3):「うまくいけばチップを払う」などの圧力は、ベンチマーク性能に有意な効果なし。
- 専門家ペルソナは事実精度を上げない(Report 4):「あなたは○○の専門家です」は、事実の正確性向上には寄与しないとの結果。
これらの結果が示すのは、丁寧な言い回しやチップの提示、専門家ペルソナの付与といった文言上の工夫は効果が安定して再現されるとは限らない一方で、タスク・前提・出力形式を明確にする構造化、使うモデルへの適合、出力を評価して反復する運用は依然として有効である、ということです。
では、これらの知見を実務にどう落とし込めばよいのでしょうか。手法・通説ごとに「実証研究での評価」と「実務での扱い」を並べてみると、取捨選択の基準が見えてきます。社内でプロンプトガイドラインを作る際の判断材料にもなるはずです。
| 手法・通説 | 実証研究での評価 | 実務での扱い |
|---|---|---|
| CoT(段階的に考えさせる) | 推論モデルでは効果わずか・時間増。通常モデルは小幅改善だがばらつき増 | 推論モデルは原則不要/通常モデルの論理タスクのみ |
| 専門家ペルソナの付与 | 事実精度の向上は確認されず | 文体・形式の指定には有効。事実確認は別途担保 |
| チップ・脅しなどの圧力 | 有意な効果なし | 使わない |
| 丁寧/命令口調 | 質問ごとにばらつき、全体では相殺 | 言い回しより指示の構造の明確さを優先 |
| 例示(Few-shot) | 形式統一・分類の安定化に寄与 | 2〜5例を厳選して使う |
| 構造化(タグ・見出し・スキーマ) | 指示とデータの混同を減らし安定 | 全モデルで推奨。基本動作にする |
出典:
Wharton Generative AI Labs「Prompting Science Report 1: Prompt Engineering is Complicated and Contingent」(2025)
Wharton Generative AI Labs「Prompting Science Report 2: The Decreasing Value of Chain of Thought in Prompting」(2025)
Wharton Generative AI Labs「Prompting Science Report 3: I’ll pay you or I’ll kill you — but will you care?」(2025)
Wharton Generative AI Labs「Prompting Science Report 4: Playing Pretend: Expert Personas Don’t Improve Factual Accuracy」(2025)
ChatGPT・Claude・Gemini別に見るプロンプト最適化の要点
実証研究で有効とされた「使うモデルへの適合」を進めるうえで、各社の公式ドキュメントを読むと、基本は共通でも最適な書き方には明確な違いがあります。とくに違いが表れるのが「思考(推論)の制御方法」と「構造化の特徴」です。この2点に得意領域を加えた3つの観点で、3モデルを見比べてみましょう。
| 観点 | ChatGPT(OpenAI) | Claude(Anthropic) | Gemini(Google) |
|---|---|---|---|
| 思考の制御 | 推論モデルは目的を高レベルで提示/汎用モデルは手順を明示。reasoning_effort等で調整 | Extended Thinkingは手順を細かく指定せず方向づけにとどめる | thinking_level/thinking_budgetで思考の深さを設定 |
| 構造化の特徴 | 見出し・セクション・出力スキーマの指定が有効 | XMLタグで指示と参照資料を明確に区切ると安定 | タグやMarkdownで指示・文脈・タスクを区切ると有効 |
| 得意領域 | 汎用性とツール/エコシステムの広さ | 長文読解・文章作成・コーディング | Google連携・長いコンテキスト・マルチモーダル |
※モデル世代・パラメータ名は更新が速いため、利用時に各社の最新ドキュメントをご確認ください。
どのモデルでも、まず「推論モードがあるか」を確認し、あれば過剰なCoTより設定で制御する。そのうえで、見出し・タグ・スキーマで指示と参照データを分離すると、指示の取り違えや誤作動を減らせます。
複数モデルを併用する会社の場合は、この構造化を社内標準にしておくと、モデルを切り替えても運用が崩れにくくなります。
出典:
OpenAI「Reasoning best practices」
Google「Prompt design strategies」
Anthropic「Prompt engineering overview」
プロンプト設計の基本となる4大要素
プロンプトの組み立ては、主に次の4要素に分けて考えると見通しがよくなります。毎回すべてを使う必要はなく、組み合わせる要素が増えるほど出力は安定していきます。
| 要素 | 役割 | 例 |
|---|---|---|
| Instruction(指示) | AIに何をしてほしいか | 「以下の文章を要約してください」 |
| Context(文脈) | 前提や背景情報 | 「これは顧客からの問い合わせメールです」 |
| Input Data(入力データ) | 処理してほしい対象 | 要約・分類したい本文そのもの |
| Output Indicator(出力形式) | 出力の形や条件 | 「要点を箇条書きで」「表形式で」 |
4要素を意識するだけでも、指示の抜け漏れは減ります。うまくいかないときは、前提や出力形式の指定に不足がないかを見直すのが近道です。
プロンプトの基本テクニックとモデル別の有効性
プロンプトの型には多くの手法がありますが、使うモデルが推論モデルか通常モデルかで有効性が変わります。
ここでは、日常業務で使う場面の多い基本のテクニックに絞って解説します。各テクニックが推論モデル・通常モデルそれぞれでどの程度有効か(◎=特に有効、○=有効、△=限定的)を、主な用途とあわせて一覧にすると次のとおりです。
| テクニック | 推論モデル | 通常モデル | 主な用途 |
|---|---|---|---|
| Zero-shot(例なし) | ◎ | ○ | まず最初に試す |
| Few-shot(2〜5例) | ○ | ◎ | 形式・分類をそろえる |
| Chain-of-Thought | △(原則不要) | ○(論理タスク) | 段階的な計算・推論 |
| 構造化(タグ/見出し) | ◎ | ◎ | 指示と参照資料の分離 |
Zero-shotプロンプティング
例を示さずそのまま依頼する最も基本的な型です。推論モデルでは、複雑なタスクでもまずZero-shotで簡潔に依頼するのが基本になります。
Few-shotプロンプティング
手本を数件示してから依頼する型で、出力の形式や分類基準を例で伝えられます。コツは質の高い2〜5例に絞ること。例を増やすほどトークンコストが増える一方で、効果は頭打ちになりがちです。
Chain-of-Thought(CoT)プロンプティング
途中の考え方を順に書かせる型です。直接答えを求めると誤りやすい計算や推論で、過程を出力させてミスを減らせます。
なお、CoTが有効なのは推論機能を持たない通常モデルです(2026年時点)。推論(Thinking)モデルに対して「ステップごとに考えて」と促すことは、各社の公式ガイドがそろってむしろ避けるよう案内しています。推論モデルには手順を示さず、目的・前提・制約・出力形式を簡潔に渡すだけで十分です。
そのほかの手法と実務での位置づけ
基本の3手法ほど日常的に使う場面は多くありませんが、AIエージェントの仕組みや複数案の検討などで名前を目にする手法があります。代表的な3つを簡単に紹介します。
- ReAct:「推論」と「検索などの行動」を交互に進める手法で、現在のAIエージェントの動作原理の基礎にあたります。
- Self-Consistency:同じ問いに複数回答を出させ、最も一貫した結論を採用。重要な判断の確からしさを高めたいときに。
- Tree of Thoughts:考えを枝分かれで展開・比較。複数案の検討や企画の発散・整理に。
業務シーン別のプロンプト例【2026年版・構造化テンプレート付き】
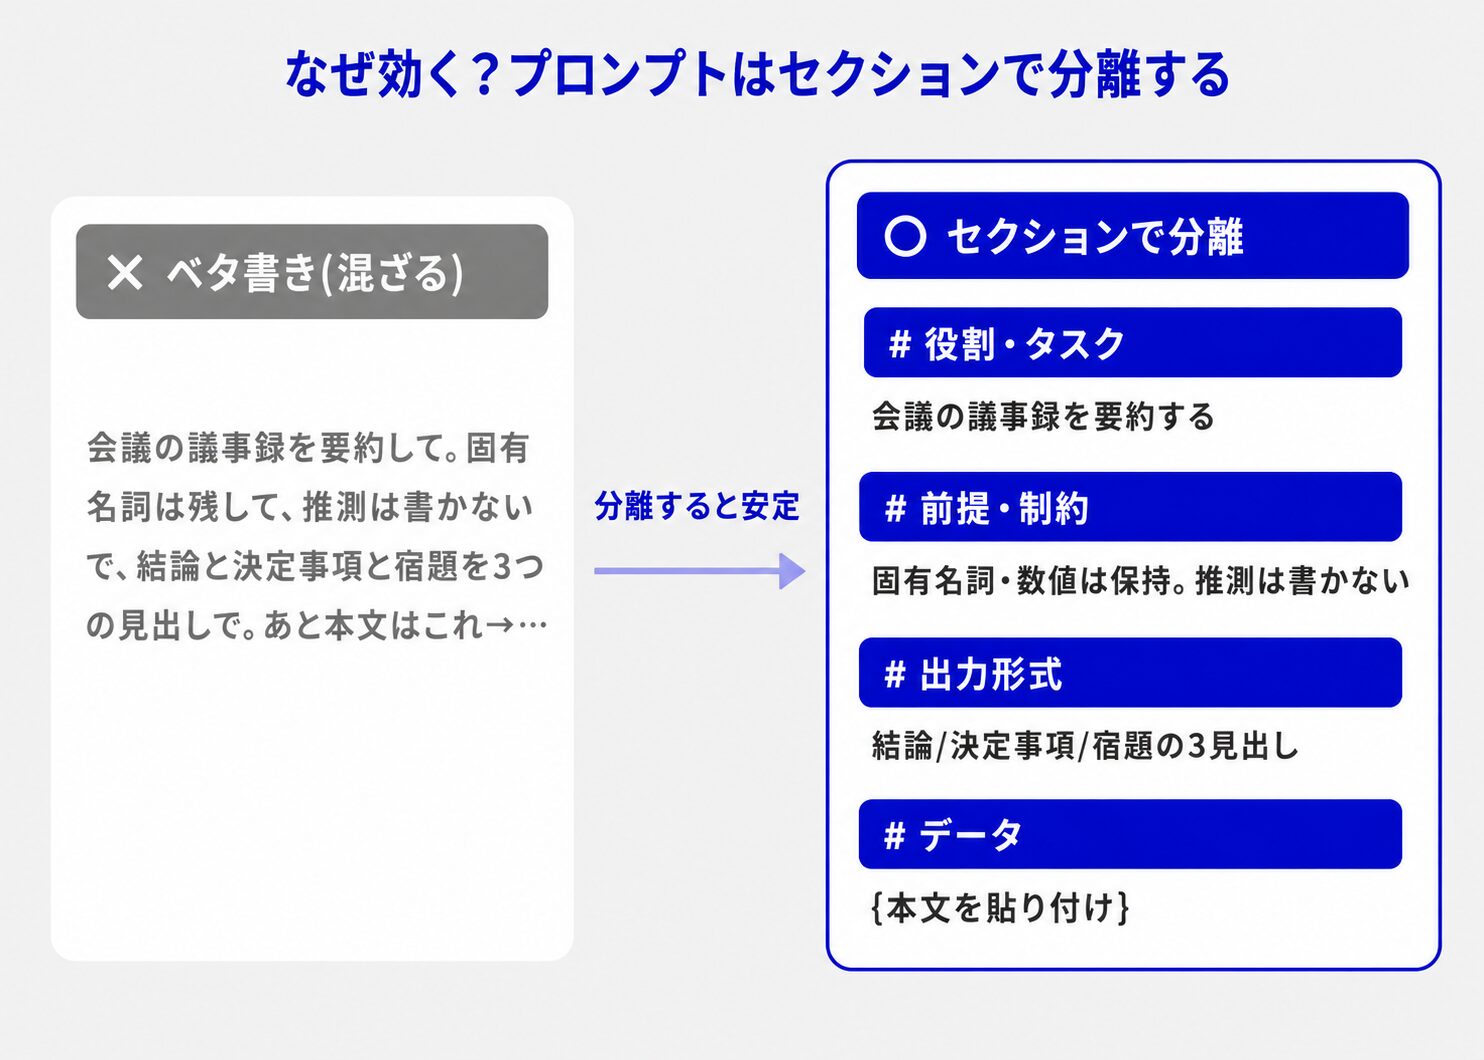
ここからは、本記事で整理した考え方を反映した実務向けのプロンプト例を紹介します。共通の方針は、セクションで指示・文脈・出力形式・データを分離し、推論モデルでは過剰な手順指示を省くことです。
いずれもChatGPT・Claude・Geminiで応用でき、{ }を自社の内容に置き換えてそのまま使えます。より多くの例は関連記事のChatGPTで使えるプロンプト集もご参照ください。
例1. 文章を要約する
対象読者や区分、制約まで指定すると、実務でそのまま使いやすい要約に近づきます。
例2. 情報を抽出・分類する
出力を表で固定すると、後工程(集計・ルーティング)に流しやすくなります。
例3. 文章を作成・校正する
トーン・文字数・出力の形を指定し、修正点も一覧で受け取ります。
例4. コードを生成・修正する
使用ライブラリや前提などの要件を明示すると、そのまま動くコードが返ってくる確率が上がります。
例5. データを分析する
「データの値のみ使用」と明記し、推測と事実を分けさせるのが安全です。
例6. 翻訳する
用途(社内/社外)を渡すだけで、文体の仕上がりは大きく変わります。
例7. 相談・アイデア出しに使う
役割と前提を渡して視点を固定すると、検討漏れに気づける指摘が得られやすくなります。
いずれも役割・文脈・出力形式・データを分けて渡す点が共通です。
こうした業務向けプロンプトは、「エクサベース AI」に150種以上のテンプレートとして標準搭載されており、自社独自のテンプレートも追加・全社展開できます。
コンテキストエンジニアリングを実践する手順とポイント
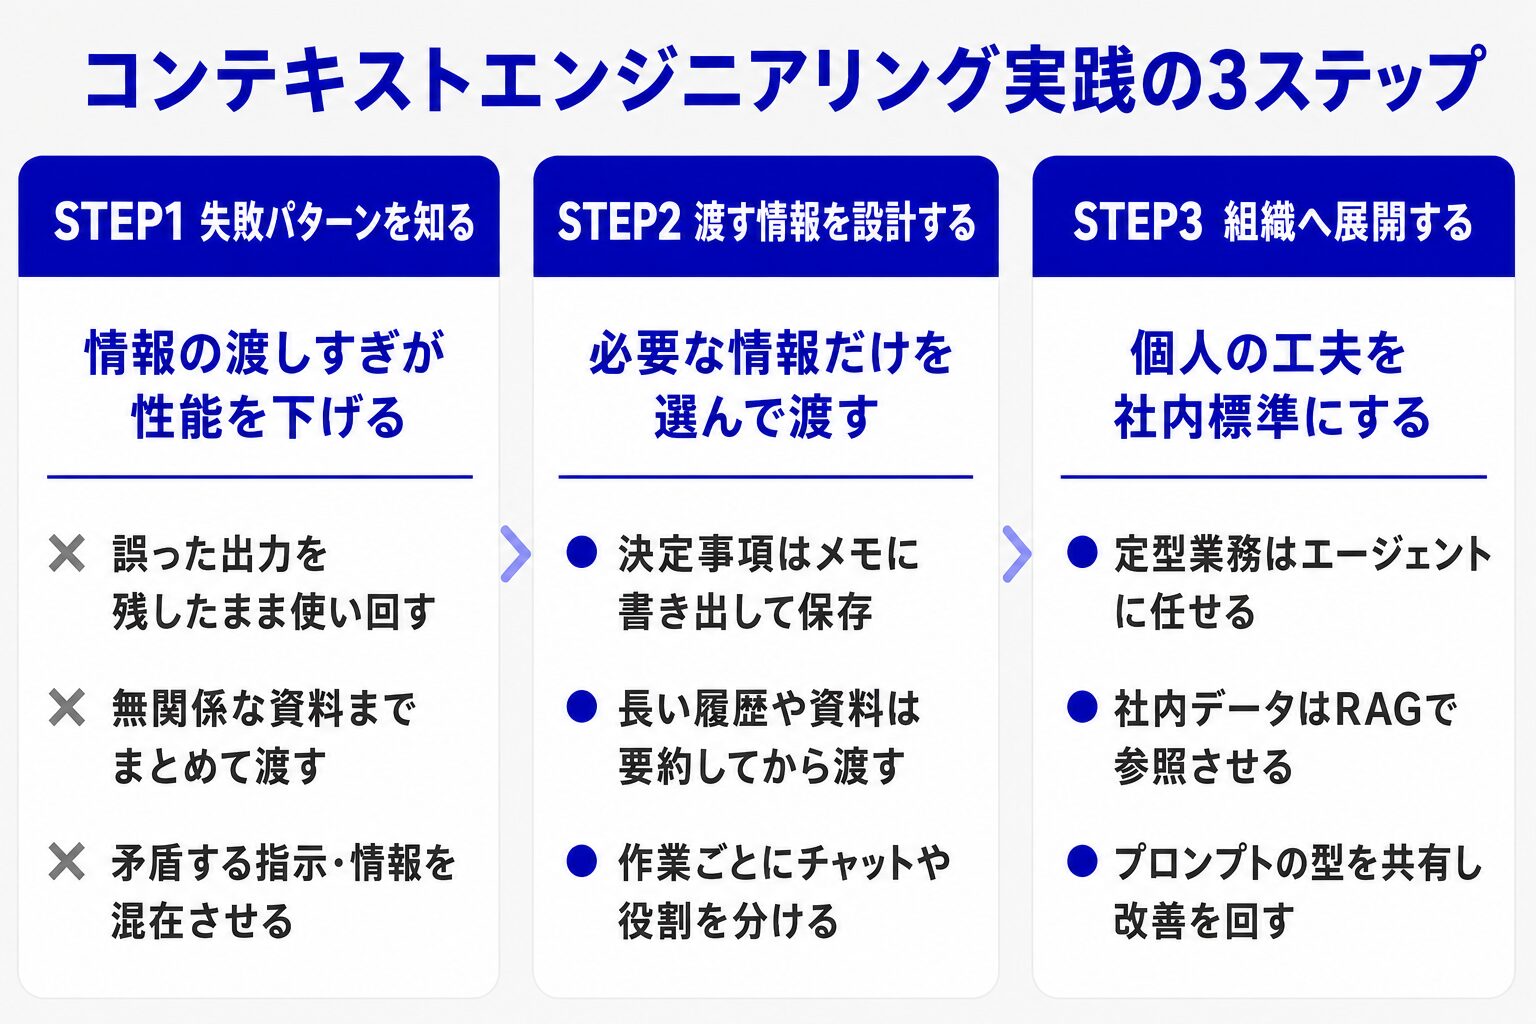
ここまでのプロンプト改善が個人の習熟だとすれば、本章で扱うコンテキストエンジニアリングは、AIに渡す情報環境を組織として設計する取り組みです。進め方は3つの手順に分けられます。まず性能を落とす失敗パターンを知り、次に4つの基本戦略でコンテキストを設計し、最後にエージェント活用と社内標準化へ展開する、という流れです。
手順1. 性能劣化を招く4つの失敗類型を知る
AIが一度に読み込める情報量(コンテキストウィンドウ)は100万トークン(トークンはAIが文章を処理する際の単位)級まで拡大し、「必要そうな資料・ツールを全部入れればよい」という期待が生まれました。しかし長い文脈は必ずしも良い回答を生みません。
この点を実証したのが、米AI企業Chroma Researchの調査「Context Rot」(2025)です。GPT-4.1・Claude 4・Gemini 2.5・Qwen3を含む18モデルで、入力が長くなるほど単純なタスクでも性能が非一様に劣化し、無関係な情報(ノイズ)を足すだけでも精度が落ちることを示しました。
モデルが一度に注意を向けられる情報量には限りがあり、「最も多いトークン」ではなく「正しいトークン」を選んで渡す必要があります。では、具体的にどんな壊れ方をするのか。実務で文脈が壊れる典型は、海外のAI実務家Drew Breunig氏が4類型に整理しています。各類型で何が起きるのか、法人での例・対策とあわせて見ていくと、自社の運用を点検するチェックリストにもなります。
| 失敗類型 | 何が起きるか | 法人での例と対策 |
|---|---|---|
| 汚染(Poisoning) | 誤りやハルシネーション(もっともらしい誤情報)が文脈に入り、繰り返し参照される | 古い・誤った社内情報の混入。出典確認と速やかな除去 |
| 注意散漫(Distraction) | 履歴が膨らみ、学習内容より蓄積履歴に過度依存する | 長い会話で過去のやり方を反復。要約・履歴の整理 |
| 混乱(Confusion) | 無関係・余分な情報やツールが回答品質を下げる | 資料・ツールの渡しすぎ。必要なものだけに絞る |
| 衝突(Clash) | 文脈内の情報が互いに矛盾し、推論が乱れる | 新旧資料や複数ツールの矛盾。一貫性とバージョン管理 |
出典:
Chroma Research「Context Rot」(2025)
Drew Breunig「How Long Contexts Fail」(2025)
手順2. 4つの基本戦略でコンテキストを設計する
具体的な設計の枠組みとして広く参照されているのが、LLMアプリ開発フレームワークLangChainによる4分類です。同社はコンテキスト設計の操作をWrite(書き出す)・Select(選ぶ)・Compress(圧縮する)・Isolate(分離する)の4つに整理しています。法人での具体策とあわせて使い分けます。
| 戦略 | 内容 | 法人での具体策・使いどころ |
|---|---|---|
| Write(書き出す) | 必要な情報を文脈の外に保存する | 作業メモ・決定事項を外部に記録。会話をまたいで引き継がれるメモリ機能で前提・ルールを保持 |
| Select(選ぶ) | 必要なものだけ文脈に取り込む | RAGで社内文書の関連箇所だけ参照(権限管理つき)。使うツールを絞る |
| Compress(圧縮) | 必要なトークンだけ残す | 長い履歴や資料を要約(コンパクション)し、文脈を軽く保つ |
| Isolate(分離) | 文脈を分割する | 役割ごとに補助のAI(サブエージェント)へ分け、結果(要約)だけを集約する |
加えて、Claude開発元のAnthropicは公式レポートで、実行時に必要な分だけ読み込むジャストインタイム取得を推奨しています。すべてを先読みするのではなく、ファイルパスやクエリなど軽量な参照を保持し、必要になった時点で取得する考え方です。
実際には「少量を先読み+実行時に動的取得」のハイブリッドが有効とされています。
長時間動く自律タスクでは、コンパクション(古い履歴の要約)・構造化ノート(外部に状態を記録し再注入)・サブエージェントの3手法が要になります。
たとえばサブエージェントは、各自が数万トークンを使って深く探索し、凝縮した要約だけを親エージェントに返すことで、全体の文脈を汚さずに分業します。
出典:
Anthropic「Effective context engineering for AI agents」(2025)
LangChain「Context Engineering for Agents」(2025)
社内文書を権限管理つきで参照するRAG(Select戦略)は、当社の「エクサベース AI」のデータ連携機能でも実現できます(フォルダ単位の権限分けに対応)。詳細はこちら。
手順3. エージェント活用へ展開し社内標準を整える
最もわかりやすい実例がコーディングエージェント(Claude Code、Codex、Cursorなど)です。リポジトリ全体を読み込み、複数ファイルの修正まで任せることができます。
こうしたエージェントで安定した成果を出す鍵は、指示文の巧拙以上に「どの情報をどう渡すか」にあるとされ、国内企業の開発ブログでも情報の渡し方を工夫した実践報告が共有されています。さらにAnthropicは、長時間自律的に動くエージェント向けに、作業環境そのものを整える「ハーネス」設計の考え方を公開しています。
普段の実務に落とすと、要点は次の4つです。
- 必要十分な情報設計:すべてを渡すのではなく、判断に効く情報だけを選別して渡す
- RAG+ガバナンス:社内文書を権限・バージョン管理のうえで連携し、汚染や衝突を防ぐ
- 評価(evals):効果はタスクや状況によって変わるため、自社タスクで出力を実測しながら設計を磨く
- 標準化:テンプレートとデータ連携の構成を社内で標準化し、属人化を避ける
出典:
Anthropic「Effective harnesses for long-running agents」(2025)
ENECHANGE Developer Blog「Claude Codeで品質の高いコードを書くために、実践から学んだコツと公式のベストプラクティス」(2025)
もっとも、コンテキストを設計するうえでも、目的や制約を的確に言語化するプロンプトの基本が出発点であることに変わりはありません。プロンプトはコンテキストの一部であり、両者は積み上げの関係です。
プロンプトエンジニアリングのリスクと対策
業務利用では、LLMの動作を悪用する敵対的プロンプトのリスクも理解しておく必要があります。代表的なものは次の3類型です。それぞれどんな攻撃で、会社やチームとして何に気をつけるべきかをあわせておさえておきましょう。
| 種類 | 概要 | 法人での留意点 |
|---|---|---|
| プロンプトインジェクション | 特殊な入力で意図しない行動を取らせ、命令の無視や情報抽出を狙う | とくに外部データ経由の間接インジェクションに注意 |
| プロンプトリーク | 指示文が保持する情報を引き出し流出させる | 指示文に含めた社内ノウハウ・前提の漏えい |
| ジェイルブレイク | 巧妙な指示でモデルの制限をかいくぐる | 更新で多くは回避されるが継続的にリスク認識を |
間接プロンプトインジェクションは、AIエージェントが読み込むWebページ・メール・社内文書などに不正な指示を仕込み、ツール連携経由で誤作動させる攻撃です。
エージェント活用が広がる2026年に、法人がとくに備えるべき論点です。
出典:
Prompt Engineering Guide「敵対的プロンプト」
法人で押さえるセキュリティ対策
対策の基本は3つです。第一に個人情報や機密情報をプロンプトに入力しないこと、第二に入力してよい情報・用途を定めた社内ガイドラインを整えること、第三に利用サービスの設計を確認することです。
会社では入力データを学習に使わせない設定や、国内で処理が完結する環境、権限管理を選べるかが判断材料になります。
- 入力してよい:公開情報、一般的な相談、社外秘を含まない下書き
- 入力を避ける:氏名・連絡先などの個人情報、未公開の経営数値、取引先の機密
- 出力は鵜呑みにせず、事実関係と著作権を確認してから使う
詳細は関連記事のChatGPTの情報漏洩リスクと対策、ChatGPTに入力してはいけない個人情報もご参照ください。
エクサベース AIで「現場で使われる」プロンプト活用を
当社グループが提供するエクサベース AIは、富士キメラ総研の調査(2026年)で国内市場シェア1位を獲得した法人向け生成AIサービスで、2023年6月の提供開始以来、1,700社以上に導入されています(2026年7月時点)。
本記事で解説した「ツール別の使い分け」「コンテキスト設計」「セキュリティ」「組織定着」を、現場で実践しやすくする機能を備えています。
| 特徴 | 内容 |
|---|---|
| 複数の最新モデルを利用 | GPT・Gemini・Claudeなど複数の最先端モデルを用途に応じて使い分け可能 |
| 150種以上のテンプレート | 精度の高いプロンプトテンプレートを標準搭載。自社独自テンプレートも追加・全社展開できる |
| RAG・データ連携 | 社内規定や各種資料(Excel/Word/PDF等)を権限管理のうえセキュアに参照 |
| AIエージェント機能 | 資料作成やデータ分析などの定型・複雑作業を自動化し、最終アウトプットまで仕上げる |
| 高度なセキュリティ | ISMSクラウドセキュリティ認証等を取得。利用状況の把握や禁止ワード登録など管理機能も充実 |
| 導入から定着まで支援 | 初期導入から現場活用・社内浸透まで一貫支援し、「使われるAI」を実現 |
プロンプトの習熟(個人)に加え、本記事で述べたコンテキストエンジニアリング(権限管理を伴うRAG・データ連携、テンプレート、ガバナンス)を組織で押さえることで、生成AIの投資を成果に変えやすくなります。
まとめ
プロンプトエンジニアリングは、生成AIから狙った成果を再現性高く引き出すための基本スキルです。2026年の要点は次の3点に整理できます。
- 使うモデルが推論モデルか通常モデルかで、書き方(とくにCoTの要否)を変える
- 言い回しなどの文言上の工夫より、タスク・前提・出力形式の構造化と、出力の評価・反復を重視する
- 個人の習熟に加え、テンプレート・データ連携・セキュリティを組織で標準化する
プロンプト単体からコンテキスト全体の設計へ視野は広がっていますが、目的や制約を的確に言語化する基本はその土台であり続けます。
組織での定着を目指す場合は、機能とガバナンスを備えたサービスの活用もあわせてご検討ください。