RAG構築の進め方|仕組みから手順・構築方法の選び方・精度を上げる打ち手まで


社内の規程やマニュアルを生成AIに読み込ませたのに、質問すると的外れな回答が返ってくる。RAG(検索拡張生成)を構築するときは、この「動かせても現場で使えない」状態をどう抜け出すかが問われます。
RAGは、生成AIに社内のデータを検索させ、その内容を根拠に回答させる仕組みです。仕組みと全体像から、構築の手順、作り方の選び方、精度を上げる打ち手までを解説していきます。
RAGの基本と構築が必要になる理由
RAG(検索拡張生成)は、生成AIに外部のデータを検索させ、その内容を根拠に回答させる方法です。モデルが記憶している知識だけに頼らず、社内の文書などから関連する情報を取り出して回答に使います。この考え方は、2020年にPatrick Lewisらが発表した論文で示されました。
出典:Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks(arXiv)(2020年5月)
RAGの仕組み
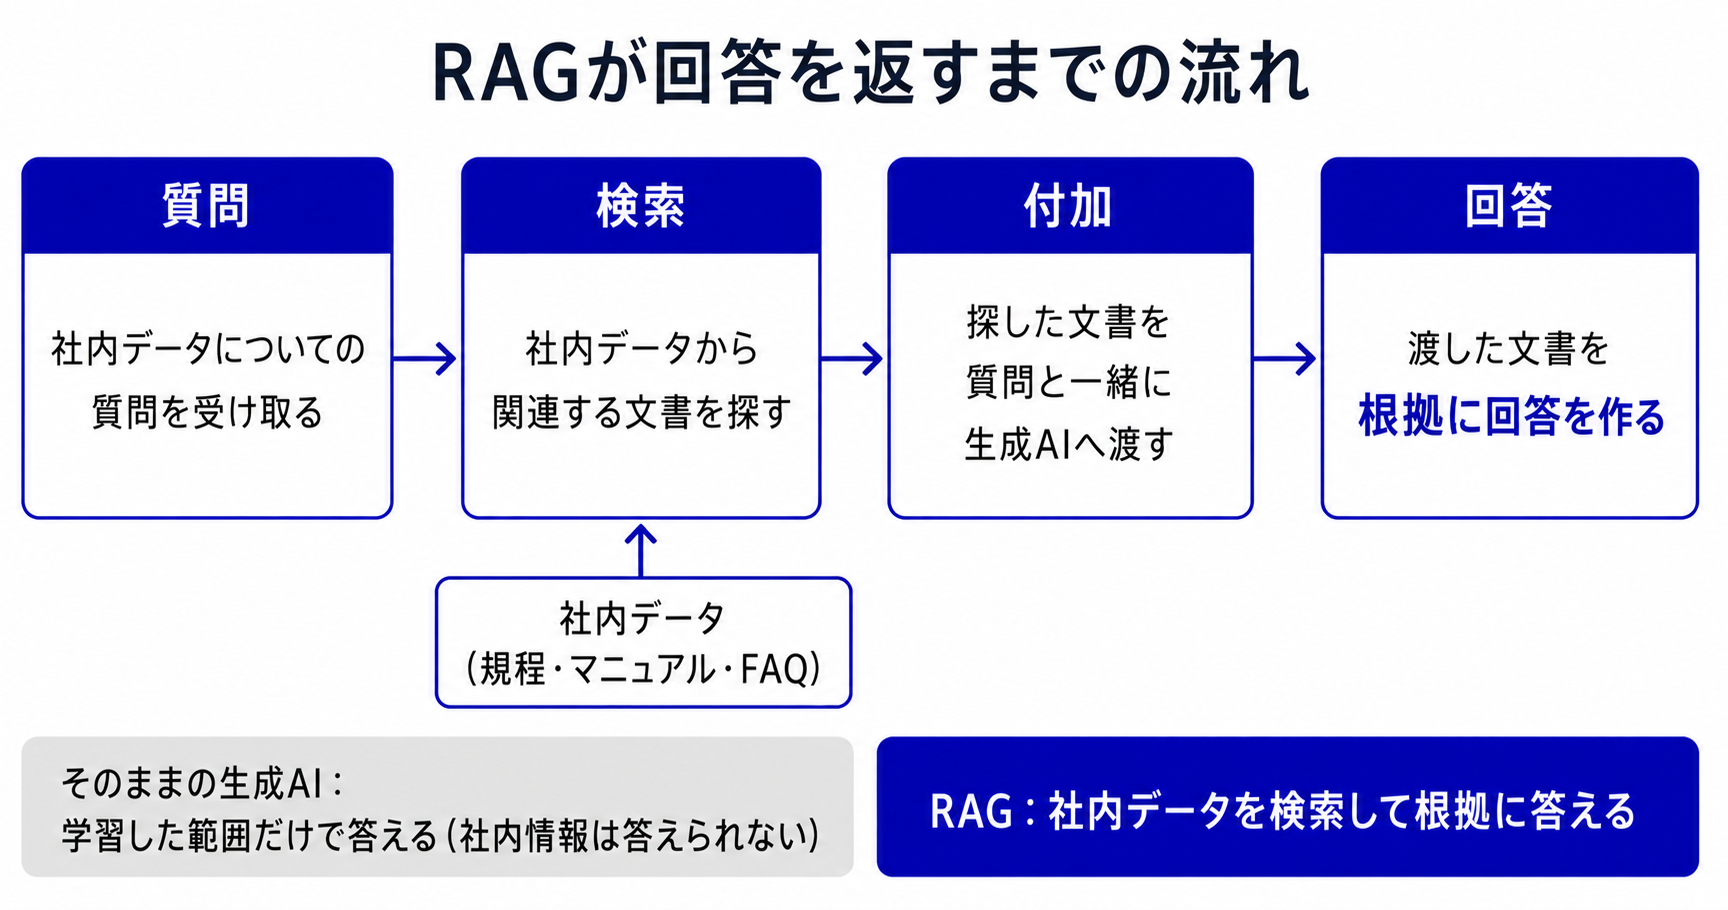
通常の生成AIは、学習した範囲の知識をもとに文章を作ります。そのため、社内の規程のように学習していない情報を聞くと、答えられないか、もっともらしい誤りを返すことがあります。
RAGは、質問を受け取ると、まず関連する情報を社内のデータから探します。その情報を質問と一緒に生成AIへ渡し、渡された内容にもとづいて回答を作らせます。
- 検索:質問に関連する文書を社内のデータから探し出す
- 付加:探した文書を質問と一緒に生成AIへ渡す
- 生成:渡された文書の内容にもとづいて回答を作る
知識を覚え込ませるのではなく、必要な資料をその都度渡して答えさせる。これがRAGの基本的な発想です。
覚えている知識だけで答える試験ではなく、資料を見ながら答える持ち込み可の試験に近い形です。答えを暗記していなくても、手元の資料を読み解いて答えられます。
そのままの生成AIとの違い
そのままの生成AIは、社内にしかない情報を尋ねても答えられません。学習した範囲の外にあるためで、RAGはその不足を検索で補います。
社内情報を扱う方法には、モデル自体に自社データを追加で学習させるファインチューニング(追加学習による調整)もあります。RAGはモデルを学習させ直さず、回答のたびに外部の資料を参照する点が異なります。
| 観点 | そのままの生成AI | ファインチューニング | RAG |
|---|---|---|---|
| 社内情報への対応 | できない | 追加学習が必要 | 検索して参照する |
| 情報の更新 | 更新できない | モデルを再学習する | データを入れ替える |
| 回答の根拠 | 示しにくい | 示しにくい | 出典を示せる |
自社の情報が頻繁に変わる場合は、データを入れ替えるだけで済むRAGが扱いやすい形です。文体や出力の形式をそろえたい場合はファインチューニングが向くため、両方を組み合わせる構成もあります。
企業がRAGを構築する理由
RAGを構築すると、生成AIを社内の業務に近い形で使えます。導入の動機になりやすいのは次の点です。
- 誤った回答の抑制:根拠となる資料を渡すため、事実と異なる回答(ハルシネーション)を減らせる
- 最新情報の反映:データを入れ替えれば、新しい規程や商品情報にも対応できる
- 社内ナレッジの活用:規程やマニュアル、FAQなど、既にある文書を回答に使える
- データの管理:参照する情報を自社の管理下に置いたまま扱える
問い合わせ対応や社内の情報検索など、正確さが求められる業務ほど、根拠を示せるRAGの価値が出ます。実際の使いどころは、次のような場面です。
- 問い合わせ対応:商品マニュアルやFAQを参照し、一次回答の下書きを作る
- 社内ヘルプデスク:規程や手順書を参照し、総務や情シスへの質問に答える
- 法務やコンプライアンスの確認:契約書や社内規則を検索し、該当する条項を示す
いずれも、答えの根拠となる文書が社内にあり、その内容に沿って正確に答えたい業務です。資料を探すのに時間がかかる仕事ほど、効果が見えやすくなります。
RAGが向く場面と向かない場面
RAGが効くのは、社内にある程度まとまった量の文書があり、その内容を根拠に答えたい場面です。逆に、扱う文書がごく少ない場合は、RAGを組まずに資料を丸ごと渡す方が簡単なこともあります。
Anthropicは、知識ベースが約20万トークン(トークンは、AIが文章を処理する際の文字のまとまりの単位。約20万トークンは、およそ500ページ分にあたります)に収まるなら、検索の仕組みを作らず全体をそのまま渡す選び方も示しています。まず自社の文書量と用途を見て、RAGを組む必要があるかを判断すると無駄がありません。
出典:Contextual Retrieval in AI Systems(Anthropic)(2024年9月)
RAG構築の全体像と処理の流れ
RAGは、いくつかの部品が順につながって動きます。全体像をつかむと、どこを作り込めばよいかが見えてきます。
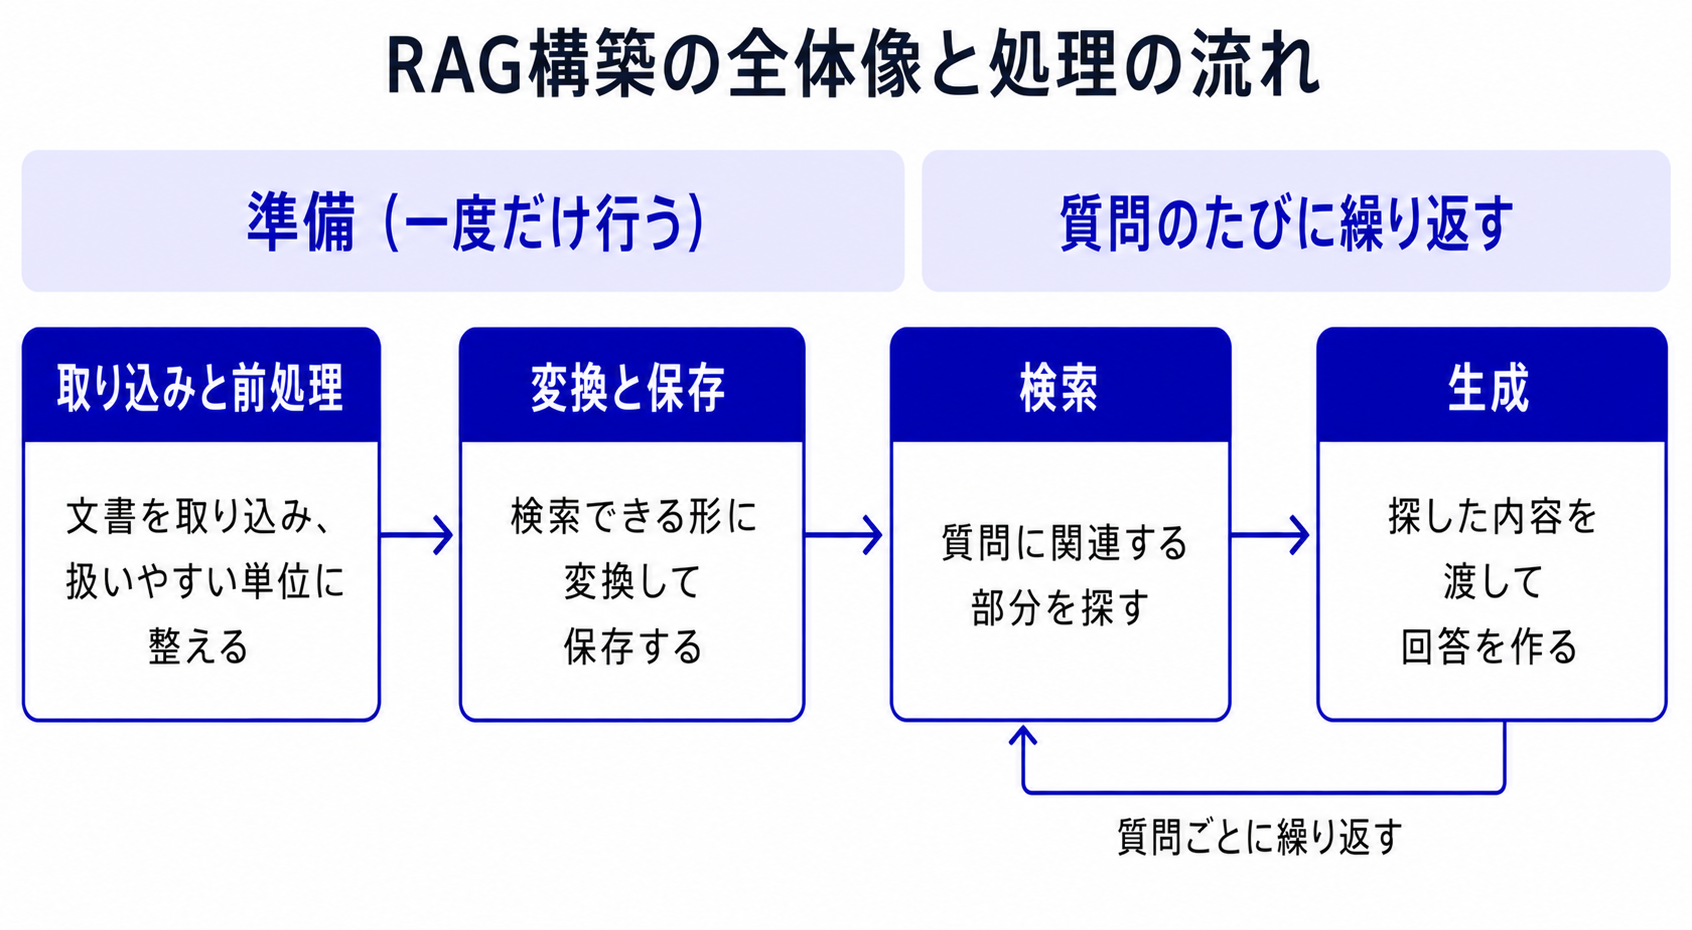
構成する要素は、大きく次の4つに分けられます。
- 文書を取り込んで、扱いやすい単位に整える
- 整えた文書を、検索できる形に変換して保存する
- 質問に関連する部分を、保存した中から探す
- 探した内容を渡して、生成AIに回答を作らせる
AWSは、この流れを、文書をあらかじめ取り込んでおく準備と、質問のたびに検索して回答する処理に分けて説明しています。準備は一度行い、検索から生成までは質問のたびに繰り返します。
出典:Understanding Retrieval Augmented Generation(AWS)(2026年7月時点)
データの取り込みと前処理
最初に、社内の文書を読み込み、検索しやすい単位へ分割します。この分割した一つひとつをチャンクと呼び、資料から取り出したテキストを小さく区切ったものを指します。
チャンクの区切り方しだいで、後の検索の精度が変わります。前処理では、次のような手当てをします。
- 表や見出しなど、崩れやすい形式を読み取れる形に整える
- 意味のまとまりが途中で切れないように区切る
- 部署名や日付など、後で絞り込みに使う情報を付けておく
チャンクを大きくすると背景の情報は保てますが、関係の薄い部分も混ざります。小さくすると要点は絞れますが、前後のつながりが切れて意味が取りにくくなるため、扱う文書に合わせて区切り方を調整します。
エクサウィザーズも、チャンクの作り方しだいでRAGの精度が大きく変わると説明しています。取り込みの質が、そのまま後工程の質につながります。
出典:生成AI・業務データ連携を運用しながら改善できる「RAGエージェント」を開始(エクサウィザーズ)(2025年6月)
検索できる形への変換と保存
分割した文書は、そのままでは意味の近さで探せません。そこで各チャンクを数値の並び(埋め込み)に変換し、意味の近い文書どうしが近くに置かれるようにします。
変換した数値は、専用のベクトルデータベースに保存します。ここに質問を同じ形に変換して問い合わせると、意味の近いチャンクを取り出せます。言葉の意味を数値で表すことで、似た意味の文書を「近いもの」として扱えるようにする処理です。
保存先には、扱う量や求める速度に応じていくつかの選択肢があります。まずは小さく始め、量が増えてから見直す形でも進められます。
質問に関連する情報の検索
質問が来ると、その質問も数値に変換し、保存済みのチャンクの中から意味の近いものを探します。これがベクトル検索で、言い回しが違っても意味が近い文書を拾えます。
探すときは、関連度の高い上位いくつかのチャンクだけを取り出します。取り出す件数を増やすと拾い漏れは減りますが、関係の薄い資料も混ざりやすくなるため、渡す量とのバランスを見て決めます。
ただし、型番や固有名詞のように、語句そのものの一致が要る質問もあります。語句の一致で探すキーワード検索と、意味で探すベクトル検索を組み合わせる方法はハイブリッド検索と呼ばれ、取りこぼしを減らせます。
取り出した情報をもとにした回答の生成
最後に、取り出したチャンクを質問と一緒に生成AIへ渡し、その内容にもとづいて回答を作らせます。渡す資料を明示するため、どの文書を根拠にしたかを出典として示せます。
根拠を示せると、回答の確からしさを後から確かめられます。参照した箇所へたどれるようにしておくと、現場での確認がしやすくなります。
渡す資料が多すぎると、生成AIが要点を絞りにくくなります。関連度の高いものに絞って渡すと、回答が安定します。
回答の質は、生成AIの性能そのものよりも、前段の検索でどれだけ的確な資料を渡せたかに左右されます。生成より検索の設計に力を注ぐと、手応えが変わります。
RAG構築の進め方
ここからは、構築を進める順番を追います。技術の選定に入る前に、目的とデータの整理を済ませておくと、後戻りが減ります。
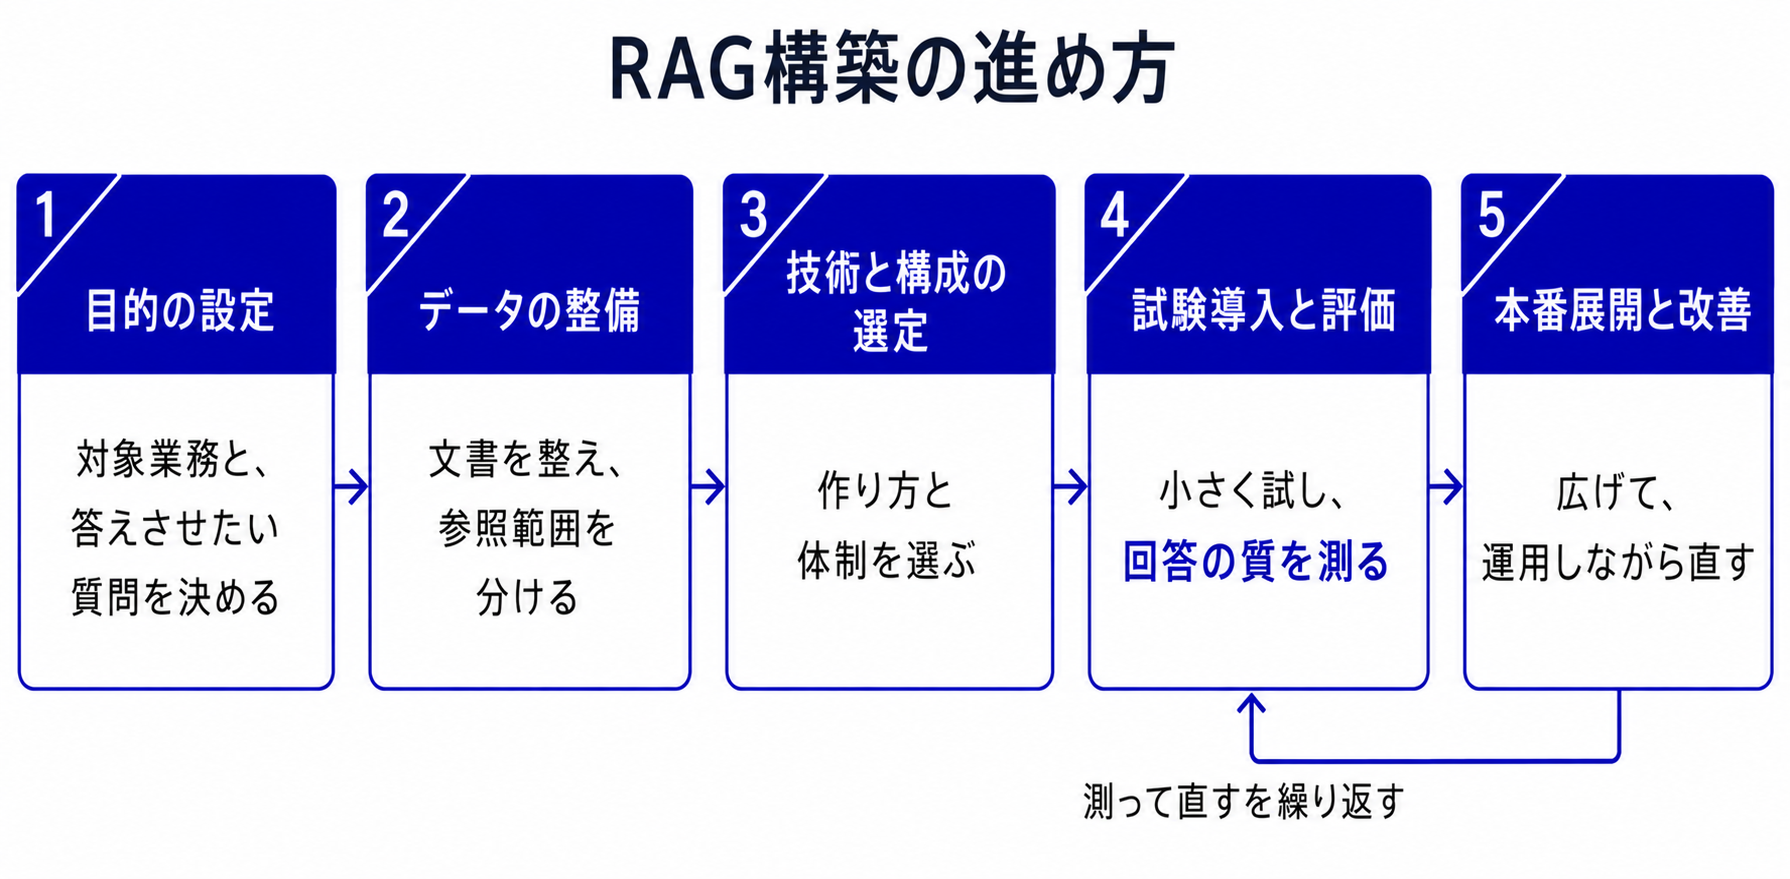
進め方の全体像は次のとおりです。
- 目的の設定:何の業務で、どの質問に答えさせたいかを決める
- データの整備:対象の文書を集め、前処理と参照範囲を整える
- 技術と構成の選定:作り方と使うサービスを選ぶ
- 試験導入と評価:小さく試し、回答の質を測る
- 本番展開と改善:現場に広げ、運用しながら直し続ける
目的と対象データの範囲を決める
はじめに、解決したい業務と質問の種類を具体的に決めます。「問い合わせ対応の一次回答」「社内規程の確認」のように、対象を絞るほど設計がぶれません。
続けて、その質問に答えるために必要な文書だけを対象にします。範囲を広げすぎると、関係の薄い資料が検索に混ざり、精度が落ちます。
はじめから複数の業務をまとめて対象にすると、必要な文書が広がって精度が出にくくなります。まず一つの業務に絞って形にすると、進め方のコツをつかめます。
- 対象業務と、答えさせたい質問の例を書き出す
- その質問に必要な文書だけを選ぶ
- 更新頻度が高い文書と、めったに変わらない文書を分けておく
データを整えて参照範囲を分ける
次に、集めた文書を前処理し、検索しやすい形に整えます。あわせて、誰にどの文書まで見せてよいかを、この段階で棚卸ししておきます。
参照範囲の整理は、後から手を入れると影響が大きい部分です。人事や契約のように、閲覧を限る文書があるなら、構築の初期に線引きを決めます。
前処理では、形式の崩れも見ておきます。PDFのレイアウト崩れや、スキャンした画像の文字はそのままでは読み取れないため、テキストとして扱える形へ変換します。
- 文書の形式をそろえ、読み取りにくい箇所を直す
- 古い版や重複した資料を取り除く
- 部署や役職ごとに、見せてよい範囲を決める
技術と構成を選ぶ
対象と範囲が固まったら、作り方を選びます。自社で一から作るのか、クラウドの構築サービスを使うのか、RAGを備えたサービスを使うのかで、必要な体制が変わります。選び方は次の見出しで詳しく整理します。
このとき、自社の要件を書き出しておくと判断がぶれません。扱うデータの機密度、想定する利用人数、社内で使える人材と、運用にかけられる工数を確認します。要件が固まっていれば、後からサービスを比べるときの物差しとして使えます。
社内に開発と運用を担う体制があるか、外部の支援を使うかも、この段階で見極めます。人材や工数が足りないまま内製に進むと、精度の調整で行き詰まりやすくなります。
小さく試して評価する
いきなり全社に広げず、限られた範囲で試験導入し、回答の質を測ります。想定する質問を集め、正しい根拠を引けているか、答えが的確かを確かめます。
評価は、感覚ではなく決めた観点で行います。次のような点を、質問のリストに沿って確認します。
- 検索が、質問に本当に関係する文書を取り出せているか
- 回答が、渡した資料の範囲に収まっているか
- 出典として示した文書が、回答の根拠として正しいか
想定質問は、現場で実際に出そうな問い合わせから集めると、評価が実態に近づきます。数をそろえすぎず、代表的なものから始めても十分に手応えを確かめられます。
本番展開と運用・改善
試験導入で手応えを得たら、対象の業務や部署を段階的に広げます。広げる際は、更新の担当と、質問への対応を見直す担当を決めておきます。
RAGは、作って終わりではありません。文書は入れ替わり、質問の傾向も変わるため、参照するデータと設定を定期的に見直す運用が要ります。
更新は、担当と頻度を決めておきます。規程のように改訂のある文書は、変わったら差し替える流れを作り、古い版が検索に残らないようにします。
RAGを構築する方法の選び方
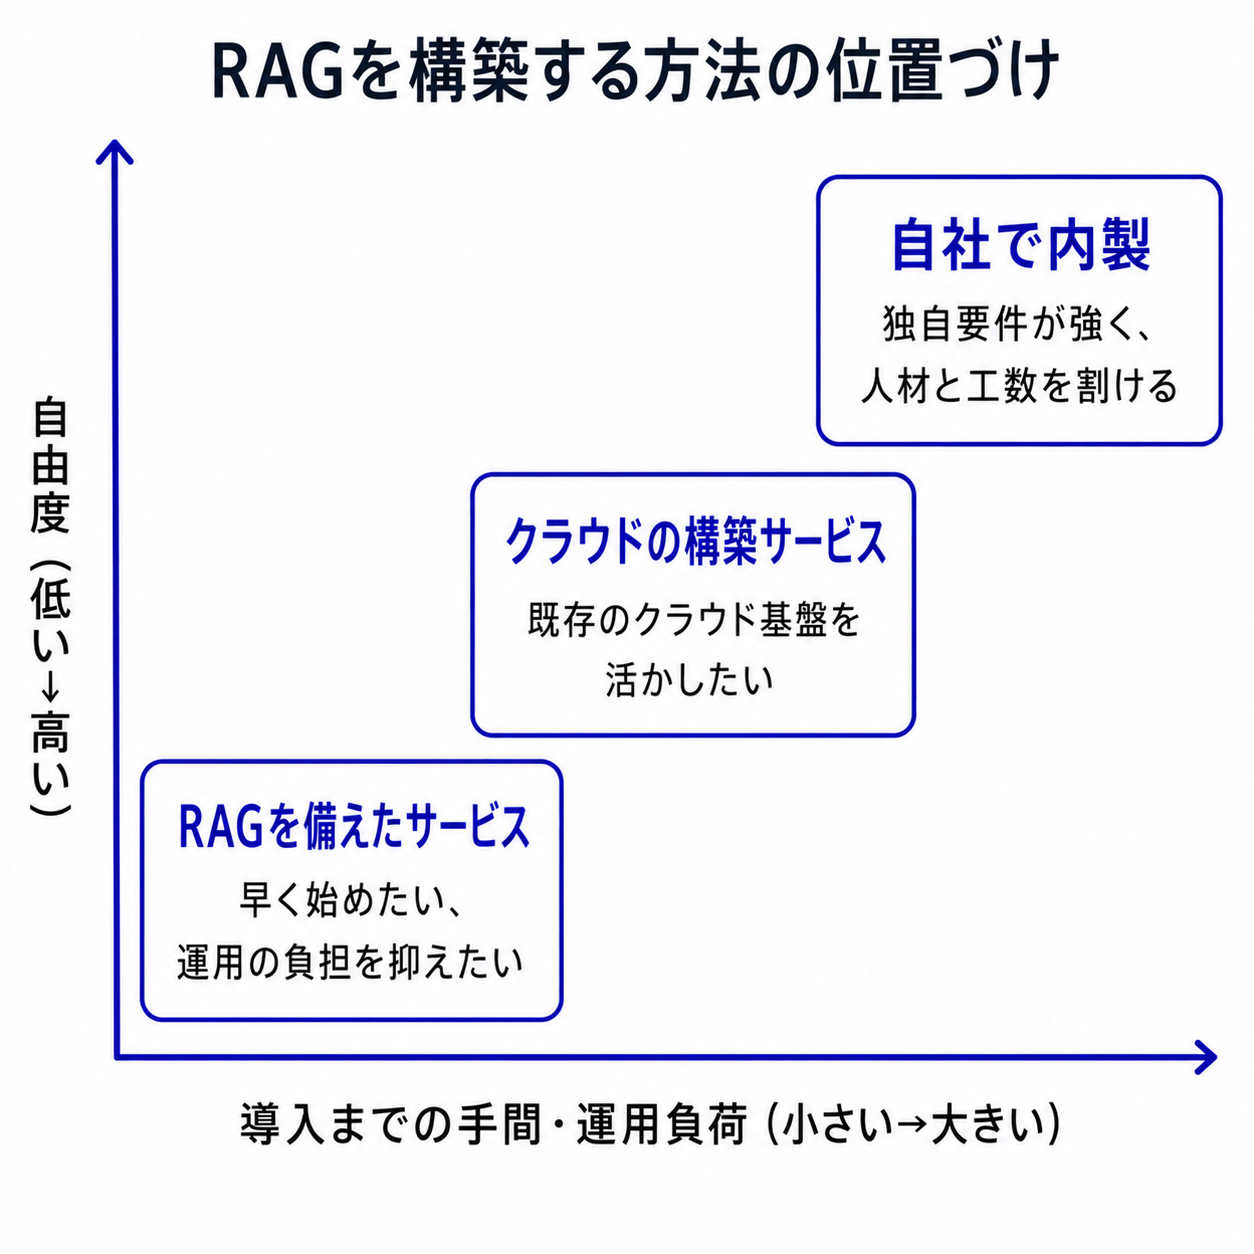
構築の方法は、大きく3通りに分けられます。自社で内製する方法、クラウドの構築サービスを使う方法、RAGを備えた生成AIサービスを使う方法です。体制やコスト、自由度が変わるため、自社の要件と照らして選びます。
自社で内製する
社内のエンジニアが、部品を組み合わせてRAGを作る方法です。一から作る場合と、開発を助ける部品群(フレームワーク)を使う場合があります。
自由度が高く、独自の要件に合わせて細かく調整できます。一方で、検索の精度を上げる調整や、その後の運用まで自社で担うため、相応の人材と工数が要ります。
フレームワークは、検索や生成をつなぐ処理をあらかじめ部品として提供し、ゼロから書く手間を減らします。それでも、精度の調整や運用は自社で担う前提です。
- 自由度が高く、独自要件に合わせやすい
- 検索方式やデータ構造を細かく調整できる
- 前処理や運用の負担を自社で持つ
クラウドの構築サービスを使う
クラウド各社は、検索や保存の部品をまとめて提供しています。これらを使うと、部品を一から用意せずにRAGを組めます。
たとえばAWSのAmazon Bedrock Knowledge Basesや、MicrosoftのAzure AI Searchが、検索や保存の機能をまとめて提供しています。既に使っているクラウドに合わせて選ぶと、社内の基盤と連携しやすくなります。
出典:Fully managed RAG options on AWS(AWS)(2026年7月時点)/RAG and generative AI(Microsoft Learn)(2026年7月時点)
AWSは、こうしたRAGの作り方を、部品を自分で選ぶ内製の構成と、必要な部品をまとめて運用の手間を省ける構成に分けて示しています。細かく作り込みたいか、手間を減らしたいかで選び分けられます。
出典:Retrieval Augmented Generation options and architectures on AWS(AWS)(2026年7月時点)
RAGを備えた生成AIサービスを使う
RAGをあらかじめ機能として持つ法人向けの生成AIサービスもあります。文書をアップロードすれば、検索から回答までを標準の機能として使えます。
作り込みの自由度は下がりますが、導入までの手間が小さく、権限管理やログといった企業利用の前提も整っています。社内で使える人材が限られる場合や、早く現場で使い始めたい場合に向きます。
社内データのアップロードや更新を、管理画面から行える製品もあります。技術者に頼らず、担当部署が運用しやすい点が利点です。
3つの方法の選び分け
主な3つの方法を、要点で比べます。
| 方法 | 導入までの手間 | 自由度 | 向いている企業 |
|---|---|---|---|
| 自社で内製 | 大きい | 高い | 独自要件が強く、人材と工数を割ける |
| クラウドの構築サービス | 中くらい | 中くらい | 既存のクラウド基盤を活かしたい |
| RAGを備えたサービス | 小さい | 低い | 早く始めたい、運用の負担を抑えたい |
費用は、作るときの初期費用と、使い続けるための運用費に分かれます。内製やクラウドの構築サービスでは、検索基盤やモデルの利用料に加え、精度を保つための運用の工数も見込んでおきます。
まず小さく成果を出したいなら、RAGを備えたサービスから始め、要件が固まってから内製を検討する進め方があります。逆に、独自の要件が明確で人材も確保できるなら、内製やクラウドの構築サービスで作り込む選び方が合います。
扱う情報の機密度が高い場合は、データを社内や国内で処理できるかも判断の分かれ目です。要件に照らして、無理なく運用を続けられる方法を選びます。
自社で一から作るには体制が足りない、けれども社内データを扱う以上は権限やログの管理まで一体で運用したい。こうした条件に当てはまる場合は、RAGを標準で備えた生成AIサービスを使う選び方があります。当社が提供するエクサベース AIは、社内データ連携(RAG)を権限やログの管理と合わせて使える法人向けサービスです。
RAG構築でつまずきやすい点と精度を上げる打ち手
RAGは、動かすだけなら短期間で用意できます。難しいのはその先で、「一応答えるが、現場で使える精度に届かない」状態から抜け出す部分です。
ここで紹介する数値は、条件が整った検証での結果である点に留意してください。RAGは、精度を上げる工夫と、使われ続ける運用があって初めて成果につながります。
検索の精度を上げる打ち手
回答が的外れになるとき、原因は生成ではなく検索の側にあります。渡す資料が的確なら、生成AIはそれをもとに答えを組み立てられます。
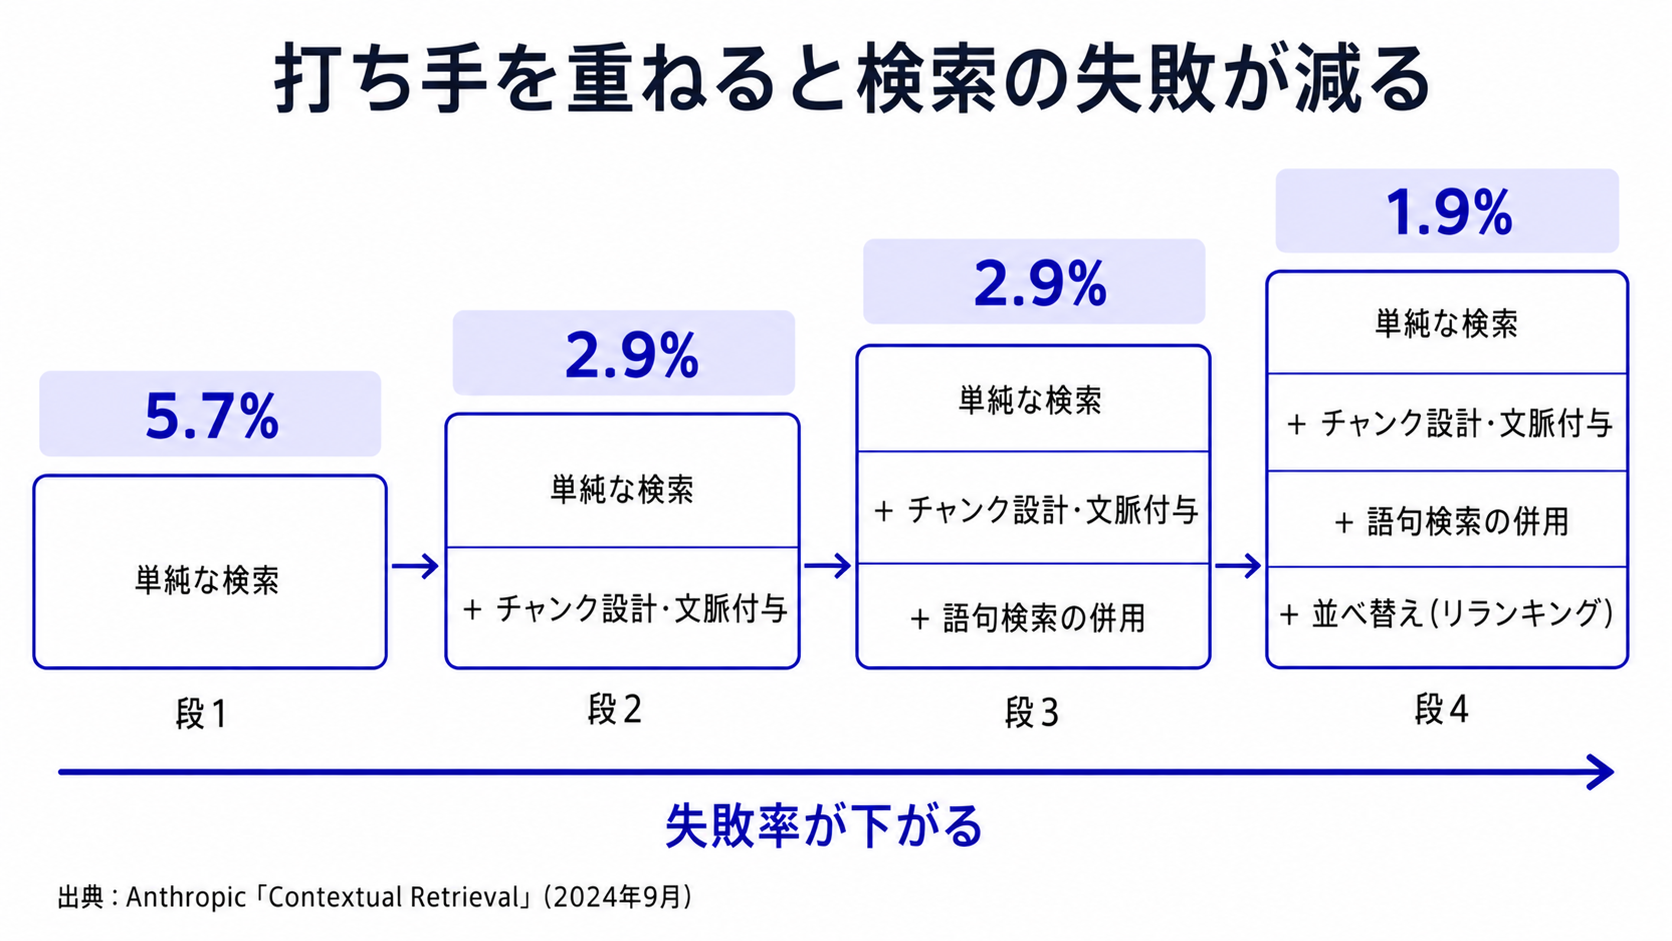
打ち手は、段階的に重ねると効果が見えやすくなります。まずチャンクの区切りを見直し、次に検索方式を組み合わせ、最後に取り出した結果を並べ替えます。
- チャンク設計:意味のまとまりで区切り、切れ目で文脈を失わないようにする
- ハイブリッド検索:意味で探すベクトル検索と、語句で探すキーワード検索を併用する
- 並べ替え(リランキング):取り出した候補を、質問との関連度で再度並べ替えて上位を絞る
Anthropicの検証では、単純な手法での検索の失敗率が5.7%だったところ、文脈を補って埋め込む方法と語句検索を組み合わせると2.9%まで下がり、さらに並べ替えを加えると1.9%まで下がりました。Microsoftも、意味と語句を組み合わせたうえで並べ替えを加える方法が、検索の関連性を明確に高めると公表しています。
質問があいまいなときは、質問自体を検索に向く形へ書き換える方法もあります。表現の揺れを補って探しやすくし、関連する文書を拾える確率を上げます。
一方で、並べ替えは処理の段階が増えるため、応答に少し時間がかかり、費用も増えます。Anthropicも、精度が上がる代わりに待ち時間と費用が増える点を挙げており、扱う量とのバランスで採否を決めます。
出典:Contextual Retrieval in AI Systems(Anthropic)(2024年9月)/Hybrid search overview(Microsoft Learn)(2026年7月時点)
データの品質と参照範囲の管理
検索の設計を整えても、元の文書が古かったり重複していたりすると、質の低い回答が出ます。RAGの精度は、参照するデータの整い方に強く依存します。
たとえば、古い版と新しい版が両方残っていると、AIが古い方を根拠にする恐れがあります。重複や矛盾を取り除き、最新の版だけを参照させると誤りを抑えられます。
もう一つ注意したいのが、参照範囲の管理です。権限を無視して全文書を横断検索すると、閲覧を限るべき情報が回答に混ざる事故につながります。質問した人の権限に応じて、参照するデータを絞る仕組みを用意しておきます。
誤った回答への対処と根拠の提示
RAGは誤りを減らせますが、ゼロにはできません。適切な情報が抽出できないと、渡した資料自体がずれ、もっともらしい誤答が生まれます。
対処の基本は、回答の根拠を示すことです。どの文書のどこを参照したかを出典として添えると、答えを受け取った側が真偽を確かめられ、誤りが独り歩きしにくくなります。
社外へ出す回答や、判断に直結する回答では、担当者が根拠を確かめてから使う運用にしておくと安全です。AIの回答をそのまま最終決定にせず、人が確認する一手間を挟みます。
評価と改善を続ける仕組み
精度は一度上げて終わりではなく、測って直す流れを続けて保ちます。想定する質問のリストを用意し、検索と回答の質を定期的に確認します。
見るのは主に2つです。検索が関係する文書を取り出せているか、回答が渡した資料の範囲に収まっているかを分けて確かめると、直すべき箇所が検索と生成のどちらかに切り分けられます。
運用の中で出た誤答は、原因を検索と生成のどちらかに切り分け、設定や文書に反映します。次のステップで回すと無理がありません。
- 確認する:想定質問で、検索と回答の質を測る
- 試す:チャンクや検索方式を一つずつ変えて比べる
- 重ねる:効果のあった調整を残し、次の課題へ進む
自社構築で不足する部分を補うエクサベース AIという選択肢
ここまで整理した構築の難所は、自社で作る場合、一つずつ手当てが要ります。汎用的に作り込む前に、標準で備わったサービスで補える部分がないかを見ておくと、投資の的が絞れます。
※2026年7月時点
構築で手のかかる点と、当社サービスで対応できる範囲を並べます。
| 構築の難所 | 自作で手当てが要る点 | エクサベース AIでできること |
|---|---|---|
| 検索の精度改善 | 前処理や検索方式の調整を自前で回す | RAGエージェントで前処理や精度検証を支援 |
| 権限・アクセス管理 | 誰にどの文書を見せるかを個別に実装 | ユーザー権限に応じて参照データを制御 |
| 複数AIモデルの使い分け | AIモデルごとに接続と切り替えを作り込む | 用途に応じて複数のAIモデルを使い分け |
| 定着・運用 | 使われ続ける仕組みを別に用意 | 導入から定着までを専門家が伴走支援 |
自社で全てを抱え込まず、標準で備わった機能に任せられる部分を見極めると、構築の負担を抑えられます。作り込むべき点と、任せてよい点を切り分けるところから始めると進めやすくなります。
当社は、法人向けの生成AIサービス「エクサベース AI」を提供しています。社内データ連携(RAG)を標準の機能として備え、権限に応じたアクセス管理やログの記録と合わせて使えます。
出典:エクサベース AI(公式)(2026年7月時点)
2025年6月には、大量の社内文書の前処理や精度の検証を支援する「RAGエージェント」の提供を始めました。運用しながら回答の品質を継続的に改善できる仕組みです。
出典:生成AI・業務データ連携を運用しながら改善できる「RAGエージェント」を開始(エクサウィザーズ)(2025年6月)
伴走支援では、業務の課題を洗い出し、使うプロンプトを整え、導入後の効果を測るところまで一緒に進めます。技術の導入だけで終わらせず、現場で使われる状態にすることを重視しています。
導入から定着までを専門家が伴走支援しており、2026年7月時点で約1,700社に導入されています。サービスの詳細は、エクサベース AIのサービスページから確認できます。
まとめ
RAGの構築は、仕組みを押さえたうえで小さく作り、精度を測って直しながら広げる流れが進めやすい形です。着手するときの順番を整理します。
- 仕組みを押さえる:検索して渡すという基本と、構成要素の流れを理解する
- 小さく作る:対象データと目的を絞り、試験導入で手応えを確かめる
- 精度を測って直す:検索の失敗を評価し、チャンク設計やハイブリッド検索、並べ替えで改善する
- 権限と運用を固める:誰にどの文書を見せるかを決め、更新と改善を続ける体制を整える
自社で一から構築する負担を抑えつつ、権限やログの管理まで一体で進めたい場合は、RAGを標準で備えたエクサベース AIをご検討ください。
※ 料金やモデルの仕様、利用上限などの最新情報は変更される可能性があるため、導入検討の際は必ず各サービスの公式ウェブサイトにて最新の金額・情報をご確認ください。
※ 記載されている会社名、製品・サービス名は、各社の登録商標または商標です。