AI半導体とは?生成AIとの関係と自社に合う計算資源の選び方を解説


生成AIを業務で使うために、最先端のAI半導体を自社で用意する必要はありません。企業が検討すべきなのは、半導体の購入ではなく、業務に必要な計算資源をどう確保するかです。費用や活用できる範囲は、計算の実行場所とモデルの規模によって変わります。
一方、半導体をめぐる報道の中心は、製造技術や供給網の競争です。そのため、AI半導体が自社の業務とどう関係し、自社で用意すべきかまでは判断できません。
本記事で扱うのは、AI半導体の定義と種類、自社調達が必須ではない理由です。あわせて、公的統計やサービス提供元の一次情報をもとに、計算資源を確保する3つの方法と制約、自社に合う選び方を解説します。
生成AIを支えるAI半導体とは
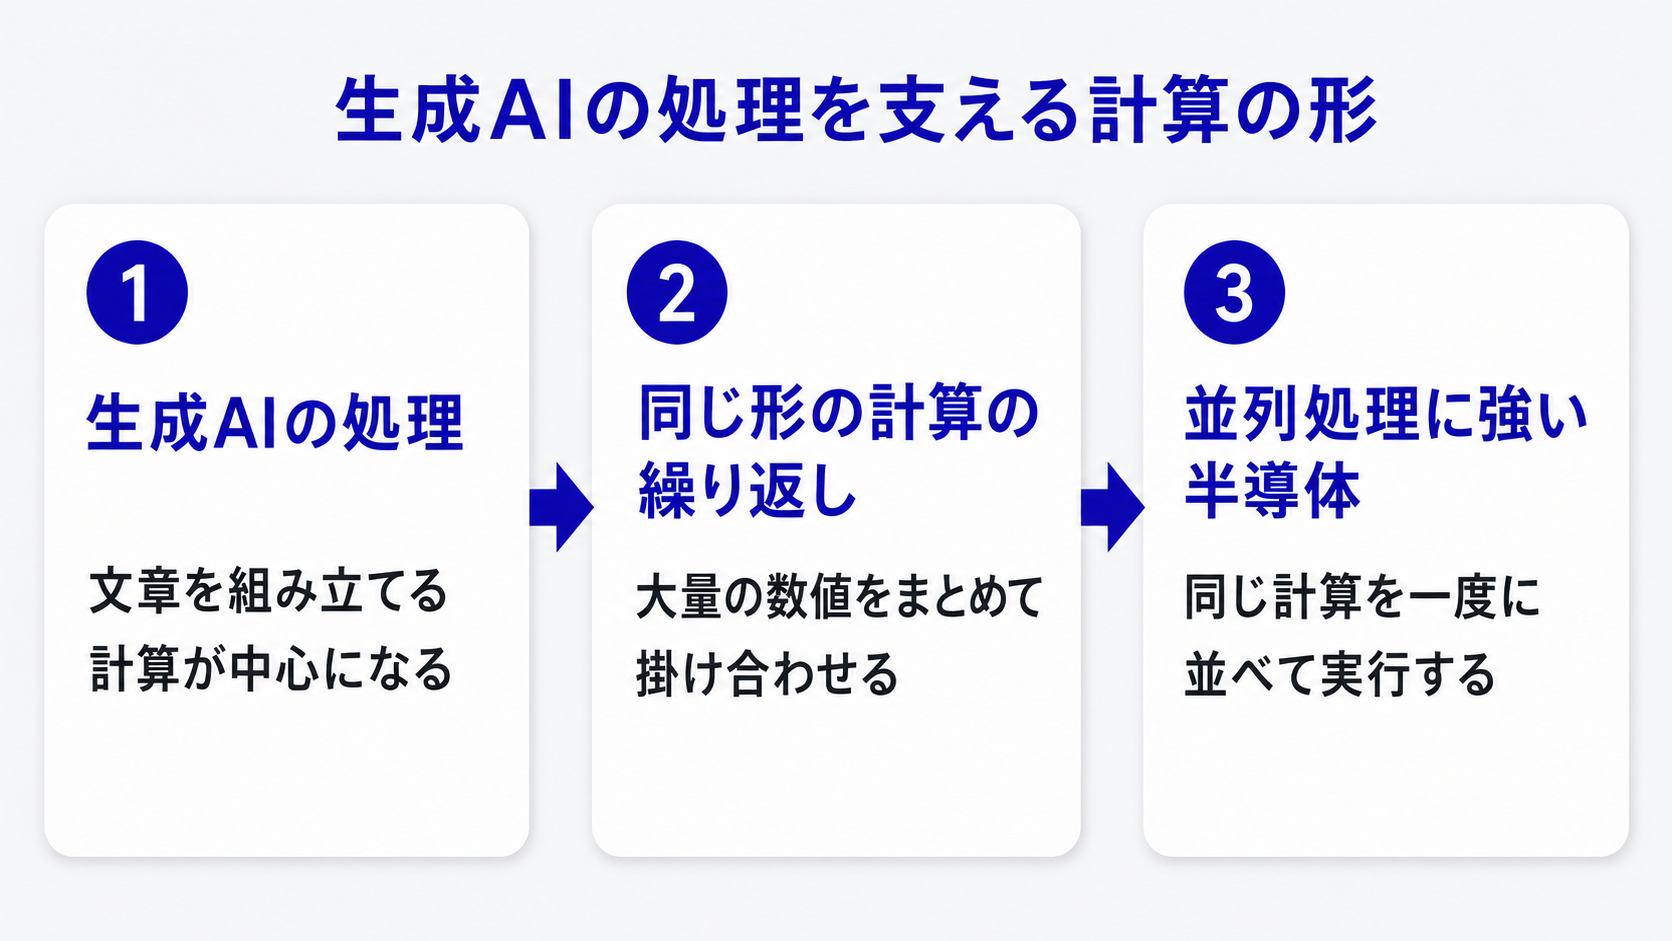
AI半導体は、AIの計算のために設計された半導体の総称です。パソコンやサーバーの中心にあるCPUは、表計算からファイル管理まで種類の異なる処理を順番にこなす設計です。そのため、同じ形の計算を一度に大量に処理する用途には向きません。生成AIが文章を組み立てる処理は、この「同じ形の計算を大量に繰り返す処理」が中心を占めます。
半導体の話題が企業の判断に結びつきにくいのは、語られている内容が製造側の競争に集中しているためです。どの企業が最先端の製造技術を握るかという論点と、自社の業務でどう計算資源を確保するかという論点とでは、必要になる情報が重なりません。
※本記事は、銘柄や株価、投資判断には立ち入らず、自社の生成AI活用の判断材料に絞って解説します。
AI半導体とCPUの違い
AI半導体とCPUの違いは、同じ形の計算をどれだけ並べて処理できるかです。CPUは複雑な手順を順番に片づける設計で、少数の処理を高速に切り替えながら進めます。一方、生成AIの計算の大半は、大量の数値をまとめて掛け合わせる行列演算です。
AI半導体は、この並列処理に的を絞って設計されました。同じ形の計算を一度に何千、何万と並べて実行できるため、生成AIの処理時間は大きく縮みます。CPUを並べて同じ速度を出そうとすると、消費電力と設置スペースの負担が見合いません。
用途が違うため、AI半導体はCPUを置き換える部品ではなく、重い計算の部分だけを引き受ける形で組み合わせて使われます。手元のパソコンにあるCPUを高性能なものに替えても、生成AIの処理が社内で完結するわけではありません。
AI半導体の3つの種類と得意な処理
AI半導体は、設計の自由度と用途の絞り込み方によって、GPU・ASIC・FPGAの3つに分かれます。GPU(Graphics Processing Unit:画像処理向けに生まれた並列計算用の半導体)は汎用性が高く、学習にも推論にも使える種類です。
ASIC(特定の用途に特化して設計された集積回路)は、処理の種類を絞る代わりに電力あたりの効率を高めています。GoogleのTPUやAWSのInferentia2が代表例です。FPGA(あとから回路の構成を書き換えられる半導体)は、仕様が固まりきらない段階の試作や特殊な処理に使われます。
3つの種類と、比較の基準となるCPUを、得意な処理・代表例・企業が触れる形で示したものが次の表です。
| 種類 | 得意な処理 | 代表例 | 企業が触れる形 |
|---|---|---|---|
| CPU(比較の基準) | 小規模なモデルや試作など柔軟さが要る処理 | サーバーやパソコンに標準で搭載 | 手元の端末・社内サーバー |
| GPU | 独自の処理を多く含む中規模から大規模のモデル | GPUクラウドが搭載するNVIDIA B200など | クラウドで借りる・自社で購入する |
| ASIC | 行列演算が大半を占める処理・数週間から数カ月に及ぶ学習 | Google TPU・AWS Inferentia2 | クラウド事業者のサービス経由 |
| FPGA | 回路を書き換えて用途に合わせる処理 | —(生成AIの業務利用では選択肢に上がりにくい) | 組み込み機器・特定用途の装置 |
出典:Google Cloud「Introduction to Cloud TPU」 / AWS「Amazon EC2 Inf2 インスタンス」
企業が選ぶ対象は、この種類そのものではありません。クラウドのサービスを通して結果としてどれかを使う形が大半で、判断の中身は自社の使い方との対応になります。
生成AIの業務利用に自社のAI半導体が必須ではない2つの理由
日本企業で自社の何らかの業務に生成AIを利用している割合は、2025年度の調査で86.4%に達しました。2024年度調査の55.2%から1年で大きく伸び、米国の90.9%、ドイツの91.6%との差も縮んでいます。
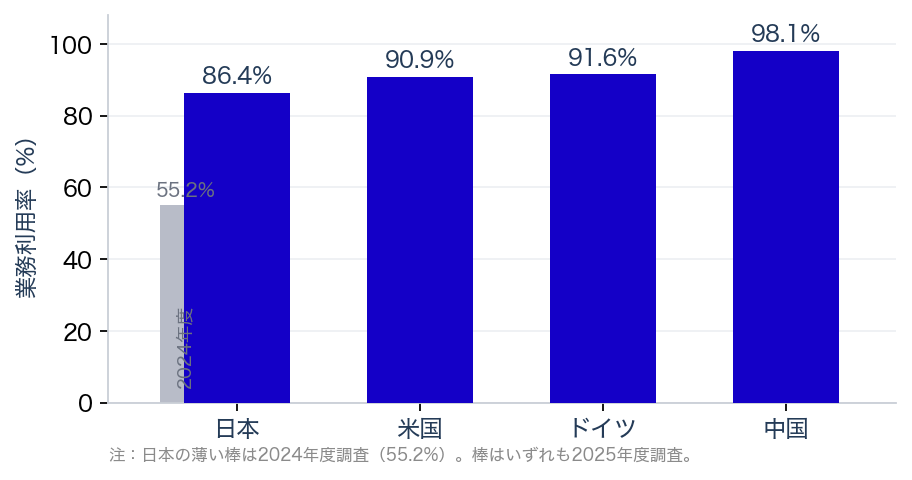
図1 企業で生成AIを一つ以上の業務に利用している割合(国別)
出典:総務省「令和8年版 情報通信白書(概要)」(2026年7月)
利用がここまで広がる一方で、本格的に導入するならまずGPUの調達から、という受け止め方も残ったままです。実際には、AI半導体を自社で持つことは業務利用の前提になりません。
内閣府と経済産業省の資料は、AIの技術基盤を演算装置(半導体)・AIインフラ・AIモデル・アプリの4つの層で整理しました。企業が業務で触れるのは上の2層で、半導体は最も下の層にあります。
出典:内閣府・経済産業省「第1回AI・半導体WG 事務局説明資料」(2026年2月12日)
半導体が働く場面も2種類です。モデルを作るための計算を学習、AIが回答を作るたびに走る計算を推論と呼び、この2つに分けて考えると自社で持つ必要のない理由が整理できます。
半導体を大量に使う学習はAI開発企業が担っている
学習を担うのは、生成AIのモデルを開発する企業です。大量のデータを読み込ませてモデルの中身を作る工程は、数週間から数カ月にわたって計算を回し続ける規模になります。Google Cloudは、TPUが適する処理として、行列演算が大半を占めるモデルと、数週間から数カ月にわたって学習するモデルを挙げました。
出典:Google Cloud「Introduction to Cloud TPU」
この規模の設備を、業務で生成AIを使うために自社で用意する必要はありません。文章の要約や議事録の作成に生成AIを使う企業が扱うのは、できあがったモデルを呼び出す側の処理です。開発企業が数カ月かけて作ったモデルを、利用する側は数秒単位で借りる形になります。
学習と推論の違いを、計算の起き方・費用の出方・担い手の3点で示したものが次の表です。
| 項目 | 学習 | 推論 |
|---|---|---|
| 計算の起き方 | モデルを作るときに数週間から数カ月続けて発生 | 利用者が指示を出すたびに短時間発生 |
| 費用の出方 | 設備と電力の大きな先行投資 | 利用量に応じた従量課金 |
| 担い手 | 生成AIのモデルを開発する企業 | 生成AIを業務で使う企業 |
表が示すのは、負担の重い側が自社の外にある点にほかなりません。自社の費用に効いてくるのは推論の側で、その額は利用量に比例して動きます。
推論に使う計算資源はクラウドで借りられる
推論に使う計算資源は、自社で買わずにクラウドから借りられるのが実情です。生成AIのAPI(外部のプログラムから機能を呼び出す接続の窓口)は、入力した文字量と出力された文字量に応じた従量課金で提供されます。モデルの大小で単価が変わるため、同じ処理量でも軽いモデルを選べば支払いは小さくなるという構造です。
推論に特化して設計された半導体も、クラウド経由で使えるようになりました。AWSのInferentia2は深層学習の推論専用に構築されたチップで、ワットあたりの性能は同等の他のインスタンスと比べて最大50%高いと説明されています。
出典:AWS「Amazon EC2 Inf2 インスタンス」
利用する側にとっては、どのチップが動いているかを意識せず必要な処理量だけを買える形です。半導体の調達という重い判断は、業務利用の入り口では発生しません。
最先端のGPUを確保した企業ほど有利だという見方もあります。その見方が当てはまるのはモデルを開発する側で、業務で使う側の判断軸は推論の置き場所と規模にあるというのが本記事の立場です。
なお、利用量が増えるほど費用の把握と利用状況の統制は課題になります。社内の利用をまとめて管理しながら生成AIを使いたい場合の選択肢が、法人向け生成AIサービス「エクサベース AI」です。
生成AIの計算資源(半導体)を確保する3つの方法
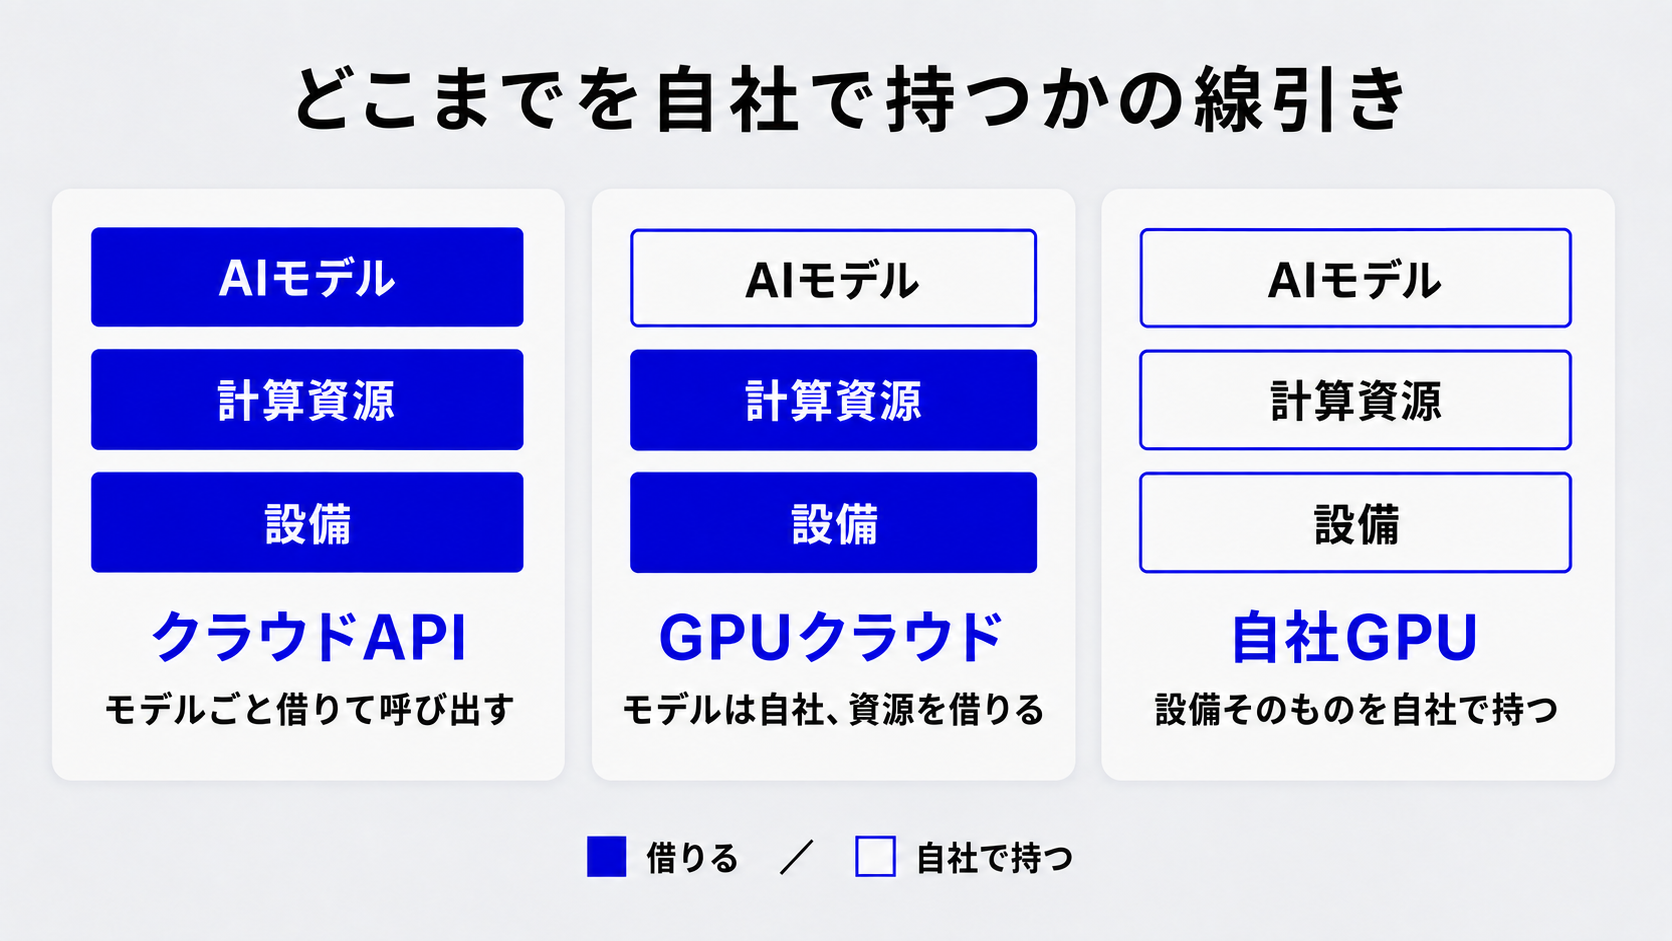
推論に使えるサービスの選択肢は、この2、3年で広がりました。GPUを積んだサーバーを時間単位で借りる形や、推論専用のチップを載せた環境など、提供のしかたは用途に応じて多様です。確保の方法は、何をどこまで借りるかで3つに分かれるという整理になります。
3つの方法を、初期費用の出方・向いているケース・機密データの扱い・必要な社内体制の4点で並べたものが次の表です。
| 方法 | 初期費用の出方 | 向いているケース | 機密データの扱い | 必要な社内体制 |
|---|---|---|---|---|
| クラウドAPI | 初期費用なし・利用量に応じた従量課金 | まず1つの業務で試す段階 | 提供元の規約と契約に従う | 利用ルールの整備 |
| GPUクラウド | 契約期間に応じた月額など | 処理量が読めてきた段階 | 自社が選んだ環境で処理 | 基盤の運用担当 |
| 自社GPU | 設備の購入費と電力・設置の固定費 | データを自社内で処理する要件がある | 自社の設備内で完結 | 設計から運用までの技術者 |
3つを分けているのは性能ではなく、どこまでを自社で持つかという線引きになります。この線引きが決めるのは、費用が変動費か固定費かという点と、データの置き場所にほかなりません。
クラウドAPIからAIモデルごと借りる
クラウドAPIは、AIモデルと計算資源をまとめて借りる方法です。自社ではプログラムから呼び出す設定だけを用意し、半導体もサーバーも提供元の環境で動きます。支払いは処理した文字量に応じた従量課金のため、使わない月の負担が小さく収まる仕組みです。
注意したいのは、入力したデータの扱いが提供元の規約で決まる点になります。社外に出せない情報を扱う業務では、契約の内容と処理される場所の確認が対象選びの前提です。確認が取れない段階では、対象を社内の一般文書に絞る運用から始める形になります。
GPUクラウドから計算資源だけ借りる
GPUクラウドは、AIモデルは自社で用意し、計算資源だけを借りる方法です。借りたサーバーの上で、公開されているモデルや自社で調整したモデルを動かします。さくらインターネットの高火力PHYは、石狩データセンターのベアメタルサーバーを月額で貸し出すサービスです。NVIDIA B200を搭載した構成も選べます。
処理量がある程度読めてきた段階では、従量課金より月額のほうが総額を抑えやすい水準です。ただし、モデルの配置や監視は自社の担当者が引き受けます。基盤を運用できる人員がいない状態では、この方法は選べません。
自社でGPUを購入して運用する
自社でGPUを購入する方法は、設備そのものを持つやり方です。データが社外に出ない形を確実に作れる一方で、費用は購入の時点でまとめて出ます。電力と冷却、設置場所の確保も自社の負担になり、設計から運用までを担う技術者も欠かせません。
稼働率が低いまま設備を持ち続けると、1件あたりの処理コストは従量課金を上回る場合があります。この方法を選べるのは、処理量が安定し、なおかつデータの要件が自社での処理を求めるケースです。逆に言えば、その2つがそろわない段階では、購入を急ぐ必要はありません。
設備を持たずに生成AIをすぐ使い始めるなら
自社で半導体もサーバーも用意せずに、社内の生成AI利用を始められる形もあります。法人向け生成AIサービス「エクサベース AI」の導入企業は2,000社、利用ユーザーは18万に達しました(※2026年11月時点)。
生成AIの半導体確保で押さえたい3つの制約
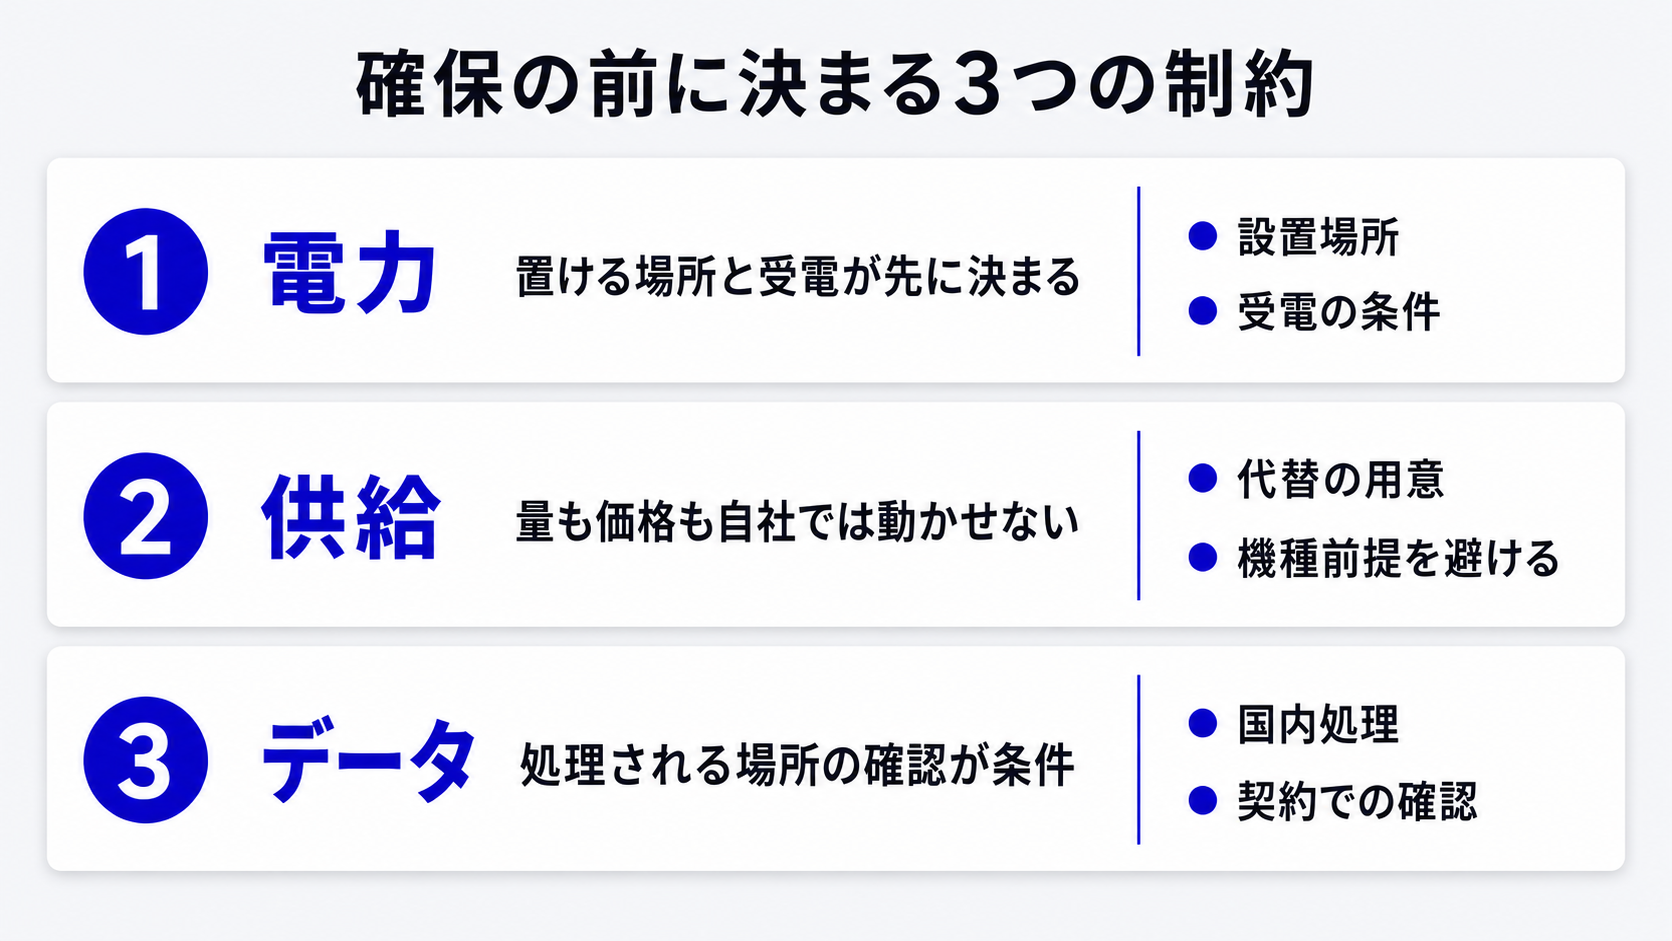
制約は、半導体そのものが買えないという形では現れません。電力・供給・データの置き場所という3つの形で、選べる方法のほうが先に絞られます。どれも個社の努力では動かしにくい条件です。確保の計画は、制約を先に織り込んだ順序で組みます。
急増するデータセンターの電力需要
1つ目の制約は、計算を動かす場所の電力です。世界のデータセンターの電力消費は、2024年に約415TWhで、世界の電力消費の約1.5%にあたります。IEAはこれが2030年には約945TWhへ倍増すると見通しました。増加分のほぼ半分は、AI向けの高速サーバーによるものです。
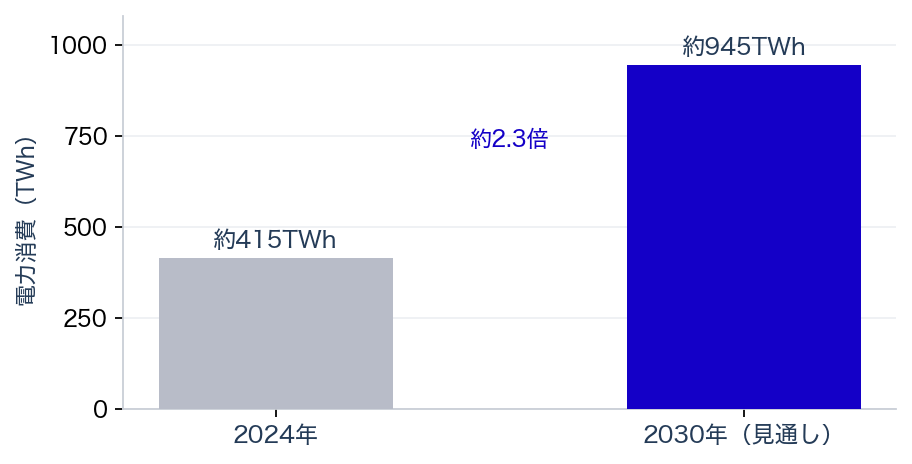
図2 世界のデータセンターの電力消費(2024年実績と2030年見通し)
出典:IEA「Energy and AI」(2025年4月)
同じ報告書では、データセンターの電力需要の伸びが2024年から2030年の世界の電力需要の伸びに占める割合は10%未満にとどまるとも示されました。電力の制約は、AIが電気を使い尽くすという形ではなく、新しい設備をどこに置けるかという形で各社の課題となります。自社でGPUを持つ計画では、設置場所と受電の条件を最初に確認する段取りを欠かせません。
国の政策に左右される先端半導体の供給
2つ目の制約は、先端半導体の供給が政策の影響を受ける点です。内閣府と経済産業省の資料は、かつて世界シェアの50%を占めた日本の半導体産業が、現在は10%未満まで落ちたと指摘しました。そのうえで政府は、AI・半導体分野で今後10年間に50兆円を超える官民投資を実現する「AI・半導体産業基盤強化フレーム」を策定しています。
出典:内閣府・経済産業省「第1回AI・半導体WG 事務局説明資料」(2026年2月12日)
供給の量も価格も、個社単独ではコントロールできない条件です。調達の計画は、確保できる前提で組むのではなく、確保できなかった場合の代替を用意する形で組みます。特定の機種を前提にした社内の設計は、入手できない時期が来ると動かせません。
▼関連記事|Anthropic、オープンモデル禁止論を否定 中国への半導体規制など3対策を要求
機密データを国内に置く要件
3つ目の制約は、扱うデータをどこに置くかという要件です。内閣府と経済産業省の資料は、AIの技術基盤を築くうえで、機微データの国内保持をはじめとする戦略的自律性を確保する必要があると指摘しています。国の方針として掲げられた論点は、個社の調達判断にも同じ形で及ぶ話です。
社外に出せない情報を扱う業務では、処理される場所を契約で確認できる方法だけが候補に残ります。確認できない方法を選ぶと、利用範囲を広げる際に必ず障壁となります。データの要件は、費用の比較より前に決める条件になります。
なお、機密データを国内で処理する必要がある場合は、国内サーバーでの処理に対応した法人向けサービスが選択肢です。データの置き場所を契約で確認できれば、社内の利用範囲も広げやすくなります。
自社に合う生成AIの計算資源(半導体)の選び方
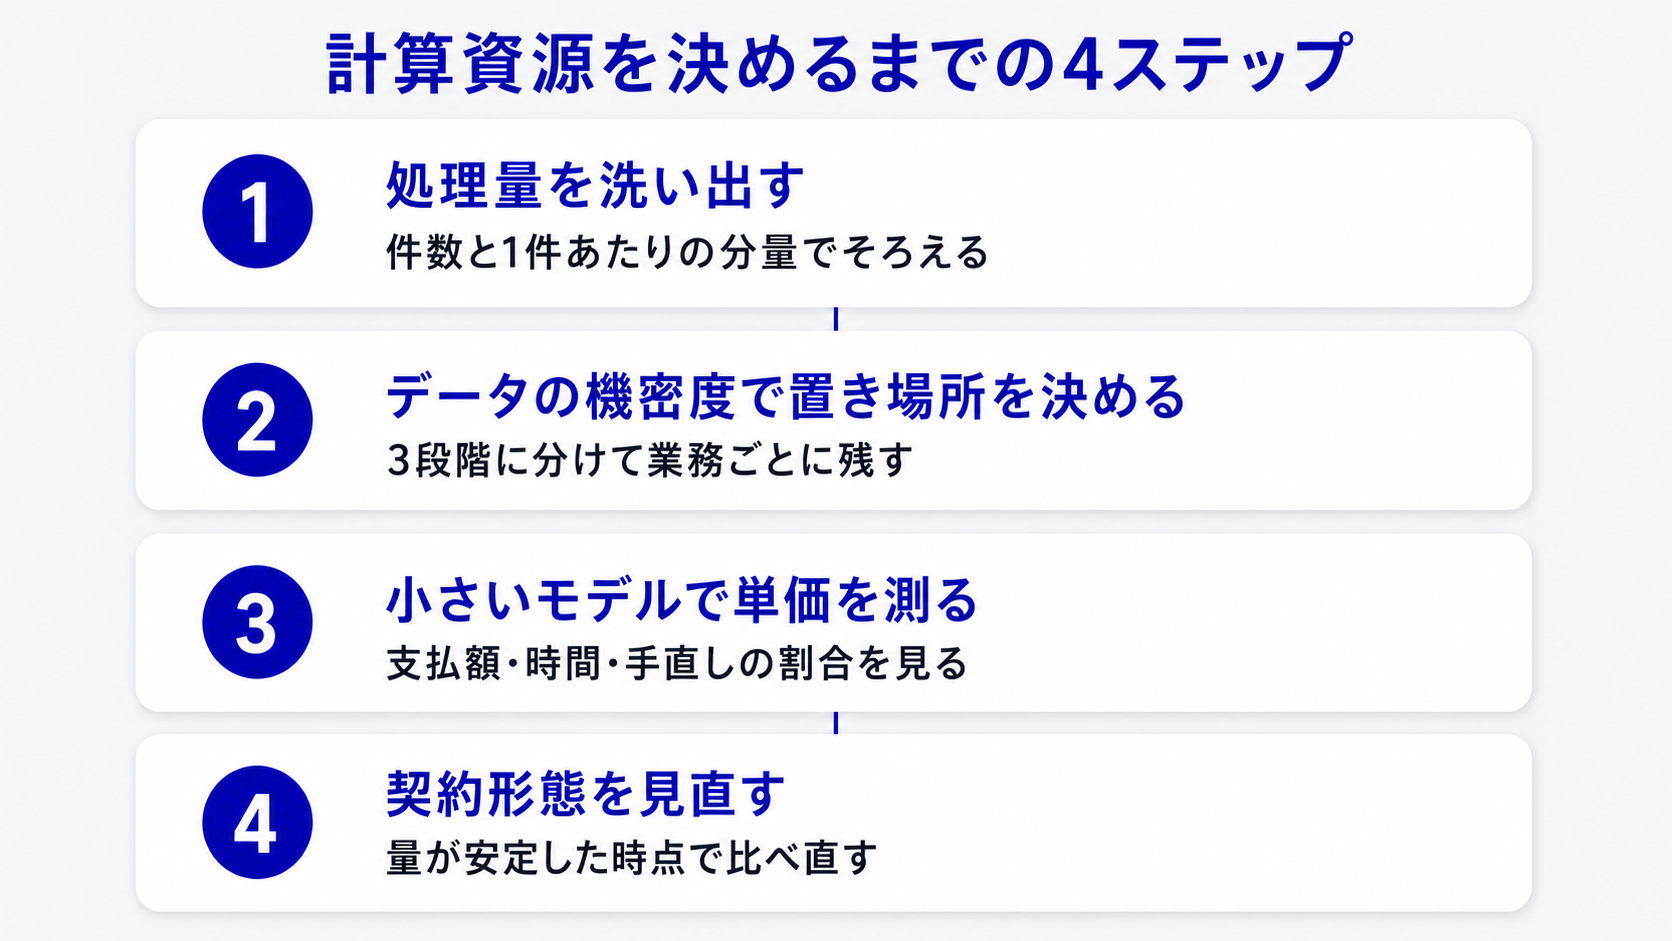
クラウドAPI・GPUクラウド・自社GPUの3つは、性能で優劣がつくものではありません。当てはめる順序を間違えると、あとから機密データの要件で作り直しになったり、想定より支払いが膨らんだりします。迷いを減らす順序は、処理量の把握・データ要件・単価の実測・契約形態の見直しという流れです。4つのステップに分けて進めます。
生成AIを使う業務と1カ月の処理量を洗い出す
最初のステップは、生成AIを使う業務と1カ月あたりの処理量の洗い出しです。処理量が分からないまま方法を選ぶと、費用の比較そのものが成り立たなくなります。出発点にしやすいのは、すでに利用が多い業務です。総務省の調査では、業務類型ごとの生成AIの活用状況を見たとき、日本では「議事録・メール作成補助」の回答割合が約7割で最も高くなりました。
出典:総務省「令和8年版 情報通信白書(概要)」(2026年7月)
洗い出しは、1カ月あたりの件数と1件あたりの分量という2つの単位でそろえます。たとえば会議の議事録を月120件、1件あたり1万文字と数えておけば、単価の計算にそのまま持ち込める状態です。件数の把握が難しい業務は、対象から外して後回しにします。
扱うデータの機密度で処理の置き場所を決める
2つ目のステップは、扱うデータの機密度による置き場所の決定です。ここを後回しにすると、方法を決めたあとで作り直す事態になります。分け方は、社外に出しても差し支えない情報、取引先との契約で守秘義務がある情報、個人情報や機微情報という3段階で十分です。3段階目に当たる業務は、処理される場所を契約で確認できる方法に限って候補に残します。
決めた区分は、業務ごとの一覧に残すのが基本です。担当者が変わったあとも同じ判断ができる形にしておけば、利用範囲を広げる場面で迷いは出ません。区分を明記しないまま進めると、利用範囲を広げる段階で必ず頓挫します。
小さいAIモデルで試して1件あたりの単価を測る
3つ目のステップは、小さいモデルでの試行と1件あたりの単価の実測です。大きいモデルほど単価は上がるため、最初から高性能なモデルを選ぶと費用の見通しは立ちにくくなります。試す範囲は、1つの部署の1業務を1カ月動かす程度が目安です。測る数字は、1件あたりの支払額、処理にかかった時間、手直しが必要だった割合の3つになります。
手直しの割合まで測るのは、削減できた時間を正しく見積もるためです。出力をそのまま使えず人が書き直しているなら、単価が安くても業務にかかる総コストは下がりません。1件あたり10円で処理できても、半分を書き直しているなら実質の単価は2倍という読み方をします。
生成AIの利用量に合わせて契約形態を見直す
最後のステップは、利用量に合わせた契約形態の見直しです。従量課金は利用が少ない段階では無駄が出にくい一方、処理量が増えると総額は読みにくくなります。月あたりの処理量が安定した時点が、月額の契約や専用の環境と比べ直す頃合いです。実測した1件あたりの単価に1カ月の件数を掛けると、比較に使える金額が出ます。
見直しは1回で終わらせず、半年ごとといった周期で繰り返すのが基本です。モデルの単価も提供されるサービスの構成も変わるため、決めた時点の前提が続くとは限りません。周期を決めておけば、単価が下がった局面で契約を戻す判断もできます。
▼関連記事|生成AIのおすすめは?目的別の比較と企業の課題から考える選び方・導入事例【2026年版】
小さく試しながら利用状況と単価を見える化するなら
部署ごとの利用状況やIDごとの利用量を把握できると、単価の実測と契約の見直しがしやすい状態です。社内の利用をまとめて管理できる法人向けサービスが、エクサベース AIにあたります。
半導体を持たずに生成AIを安全に使う選択肢:エクサベース AI
半導体を自社で持たずに生成AIを業務で使う場合、押さえる条件は3つです。処理される場所を確認できること、入力した情報が外部の学習に使われないこと、だれが何に使ったかを追えることが挙げられます。
入力したデータを国内サーバーで処理しAIの学習に使わせない仕組み
エクサベース AIは、法人での利用を前提に設計された生成AIサービスです。データ処理は国内のサーバーで行われ、入力した情報はモデルの学習へ提供されません。IPアドレス制限とログ記録によって、利用の範囲と履歴も管理できます。
ISO27001、ISO27017、ISO27701の認証を取得し、導入企業は2,000社、利用ユーザーDは18万IDに達しました(※2026年11月時点)。
出典:エクサウィザーズ「エクサベース AI」(2026年11月時点)
金沢市は半年間で3,216時間の業務時間を削減
導入の効果として公表されている例が、金沢市の削減時間です。金沢市は、自治体向けのエクサベース AIをLGWAN(自治体向けの閉じたネットワーク)で運用しました。2024年度下半期の削減効果として、3,216時間を公表しています。内訳は、文書業務の要約や原稿作成、レビューで2,298時間、コード作成業務で918時間でした。
出典:エクサウィザーズ「半期の削減効果は3,216時間 LGWAN対応だから実現できた、シームレスな生成AI活用」
職員3,269名(2024年4月1日現在)の規模で、半年間で生まれた差です。自社で半導体を持たない形でも、業務時間の削減という成果は積み上がります。
自社の業務量とデータの要件に対してどの確保方法が合うかを検討したい場合は、エクサベース AIのサービス資料をご覧ください。
※効果は利用状況や業務内容により異なります 
まとめ
企業の生成AI活用で費用と実現できる範囲を決めるのは、学習用の最先端半導体を確保できるかどうかではありません。AIが回答を作るたびに走る推論を、どこで動かし、どの大きさのモデルで処理するかが分かれ目になります。
確保のしかたは、クラウドAPI・GPUクラウド・自社GPUの3つです。判断の軸は、費用が変動費で出るか固定費で出るかと、データを置ける場所の2つに整理できます。電力・供給・データ要件という3つの制約は、この判断より前に効いてくる前提です。
進め方は、使う業務と処理量を洗い出し、データの機密度で置き場所を決め、小さく試して単価を測り、利用量に合わせて契約を見直す流れになります。半導体の調達から考え始める必要はありません。
※ 料金やモデルの仕様、利用上限などの最新情報は変更される可能性があるため、導入検討の際は必ず各サービスの公式ウェブサイトにて最新の金額・情報をご確認ください。
※ 記載されている会社名、製品・サービス名は、各社の登録商標または商標です。