生成AIのワークフローとは?仕組み・できること・始め方を解説


生成AIを業務で使う企業は増えています。ただし、利用がチャット画面での質問や文章作成にとどまると、個人作業を短縮できても、部署をまたぐ業務全体の改善にはつながりにくいのが実情です。成果を得るには、どの工程を自動化し、どこに人の判断を残すかを先に定める必要があります。
生成AIワークフローの要点は、すべてを生成AIに任せることではありません。入力・分岐・承認・記録などの定型処理はルールでつなぎ、要約や分類など判断を伴う工程だけに生成AIを組み込みます。この組み分けが、処理の再現性と業務時間の削減を両立させる基本です。
本記事では、生成AIワークフローの定義から、RPA・AIエージェントとの違い、5つの構成要素、ツールの4タイプを整理します。本記事では、一次情報と公表事例をもとにした導入の進め方から運用上の注意点までを解説します。
生成AIのワークフローとは業務の流れに生成AIを組み込んで自動化する仕組み
生成AIのワークフローとは、業務の手順を先に決め、その途中に生成AIの処理を差し込んで自動で流す仕組みです。1回の質問に1回の回答が返るチャットと違い、取得から生成、確認、記録までが一続きにつながります。
RPAの進化版と受け取られることもありますが、両者は担う役割が違い、置き換える関係にはありません。決まった画面操作の代行はRPA、内容の意味を扱う処理は生成AIと分担させます。
総務省の調査では、自社の何らかの業務で生成AIを利用していると答えた日本企業は86.4%に達し、2024年度調査の55.2%から大きく伸びました。
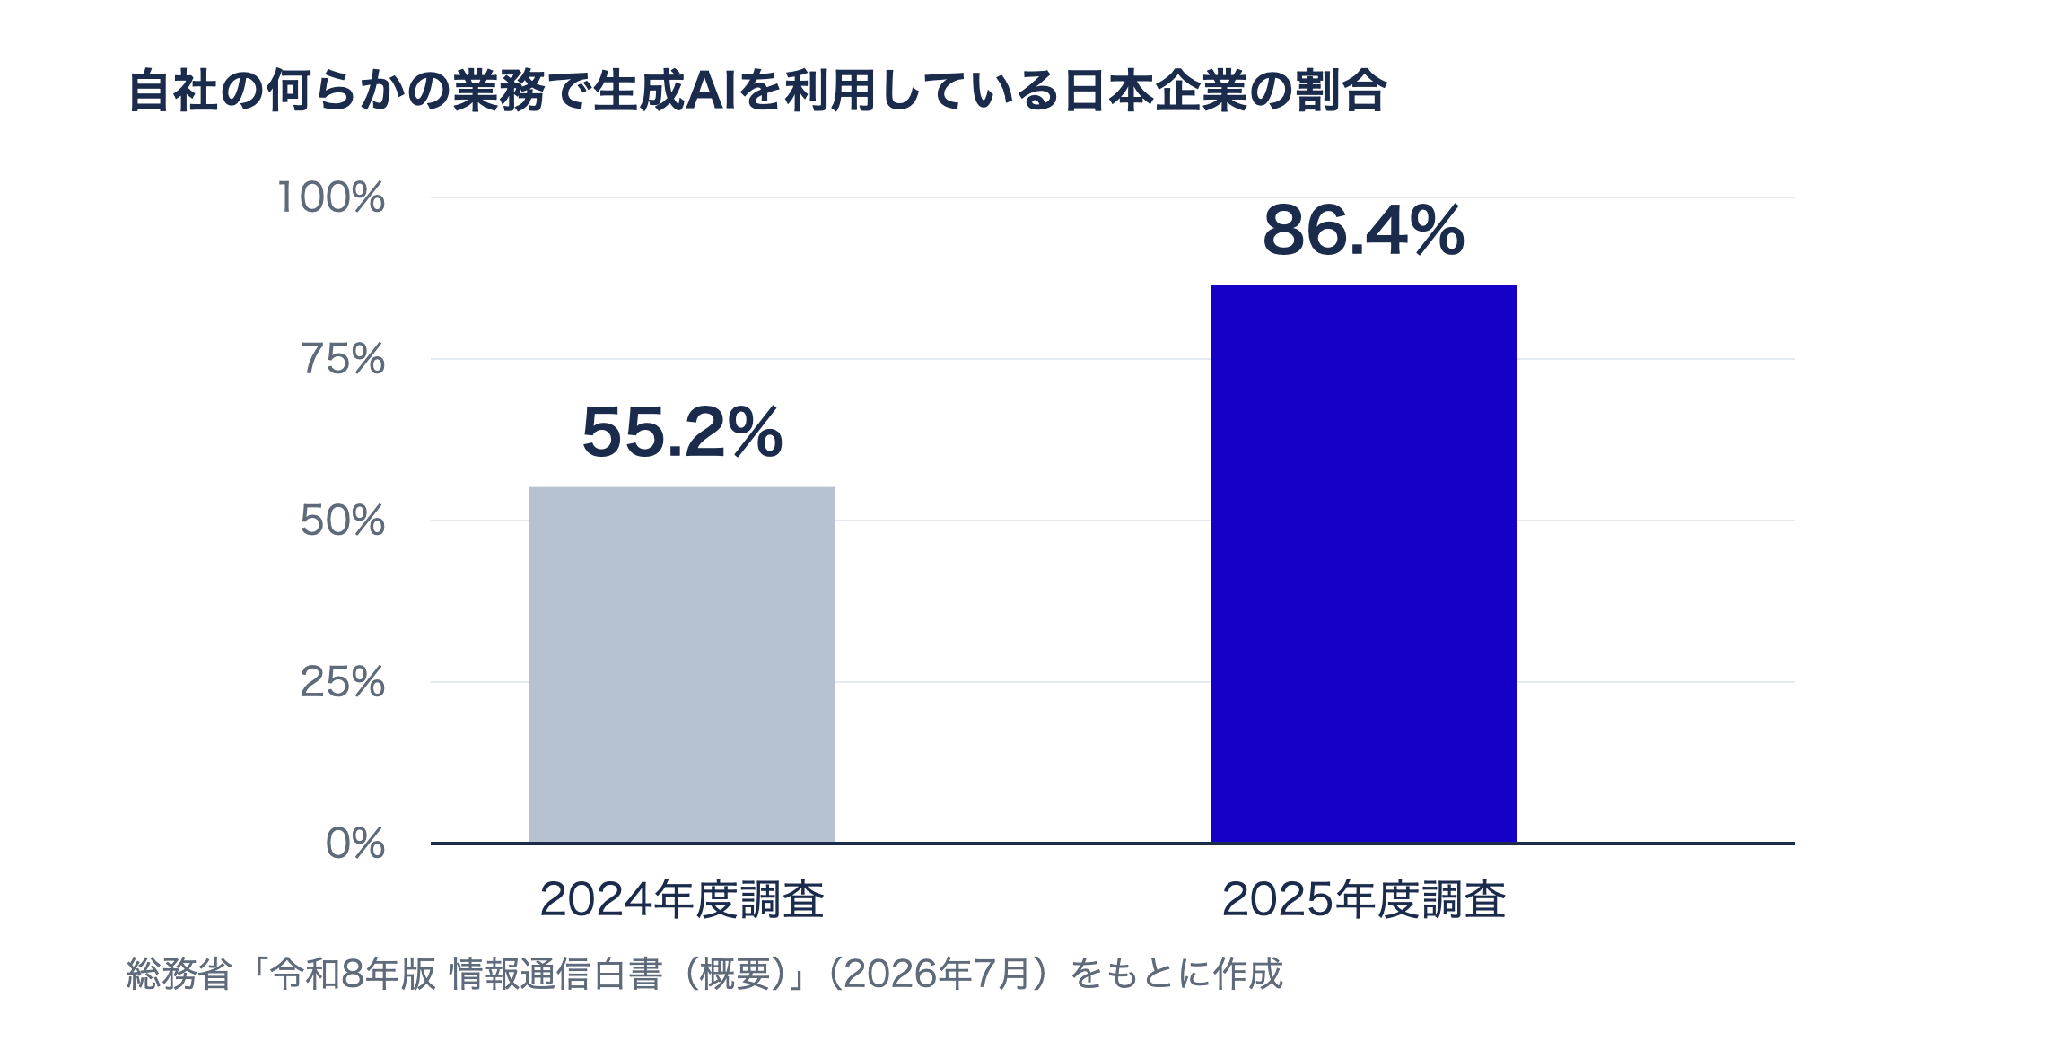
図1 日本企業で生成AIを一つ以上の業務に利用している割合
出典:総務省「令和8年版 情報通信白書(概要)」(2026年7月)
RPA・AIエージェントとの違いを、動き方と判断の担い手で整理します。
| 項目 | 動き方 | 判断の担い手 | 向く業務 | 例 |
|---|---|---|---|---|
| RPA | 記録した操作を順序どおり再生 | 人 | 転記・システム入力 | 請求書データの登録 |
| 生成AIのワークフロー | 決めた順序で流し途中を生成AIが処理 | 手順は人・判断は生成AI | 要約や分類を含む定型業務 | 問い合わせの分類と回答案作成 |
| AIエージェント | 目標を与えると手順を自分で決める | 生成AI | 手順を決めきれない調査・例外 | 条件の違う調査依頼 |
手順も判断も人が決めるのがRPA、工程内の判断だけを預けるのがワークフロー、手順の組み立てまで任せるのがAIエージェントです。3つを分ける軸は、手順と判断をだれが持つかという点になります。
RPAとの違い
RPAとの違いは、書かれている内容の意味を扱えるかどうかです。RPA(Robotic Process Automation:人のパソコン操作をソフトウェアが代行する仕組み)は、記録した操作を順序どおりに実行します。画面の項目名が変われば処理は止まり、届いた文章が苦情なのか見積依頼なのかを読み分けることもできません。
実務では両方を組み合わせ、添付ファイルの取得や基幹システムへの入力はRPA、本文の要約と分類は生成AIが担うと、自動化できる範囲は広がります。
AIエージェントとの違い
生成AIワークフローとAIエージェントは、どちらも言語モデルと外部ツールを組み合わせる仕組みです。違いは、処理の順序や分岐条件をあらかじめ人が設計するか、目標に応じてモデルがその都度判断するかにあります。決めた経路を繰り返すのが前者、状況に応じて次の行動を選ぶのが後者です。
Anthropicは、あらかじめ定めたコード経路で言語モデルとツールを動かす仕組みをワークフロー、モデルが処理とツールの使い方を動的に決める仕組みをエージェントと整理しています。
経路が固定されたワークフローの強みは、どの入力がどの処理を通ったかを確認しやすく、想定外の出力が出た箇所も特定しやすい点です。対して、エージェントは目的に応じて経路が変わるため、定型業務では動作の確認と再現に手間がかかります。そのため、申請処理や定型レポート作成のように流れが決まった業務はワークフローで組み、事前に手順を定めにくい探索的な工程だけをエージェントに任せます。
出典:Anthropic「Building effective agents」(2024年)
▼関連記事|AIエージェントと生成AIの違いとは?仕組み・できること・企業の活用事例から見る導入の進め方【2026年版】
生成AIのワークフローを構成する5つの要素
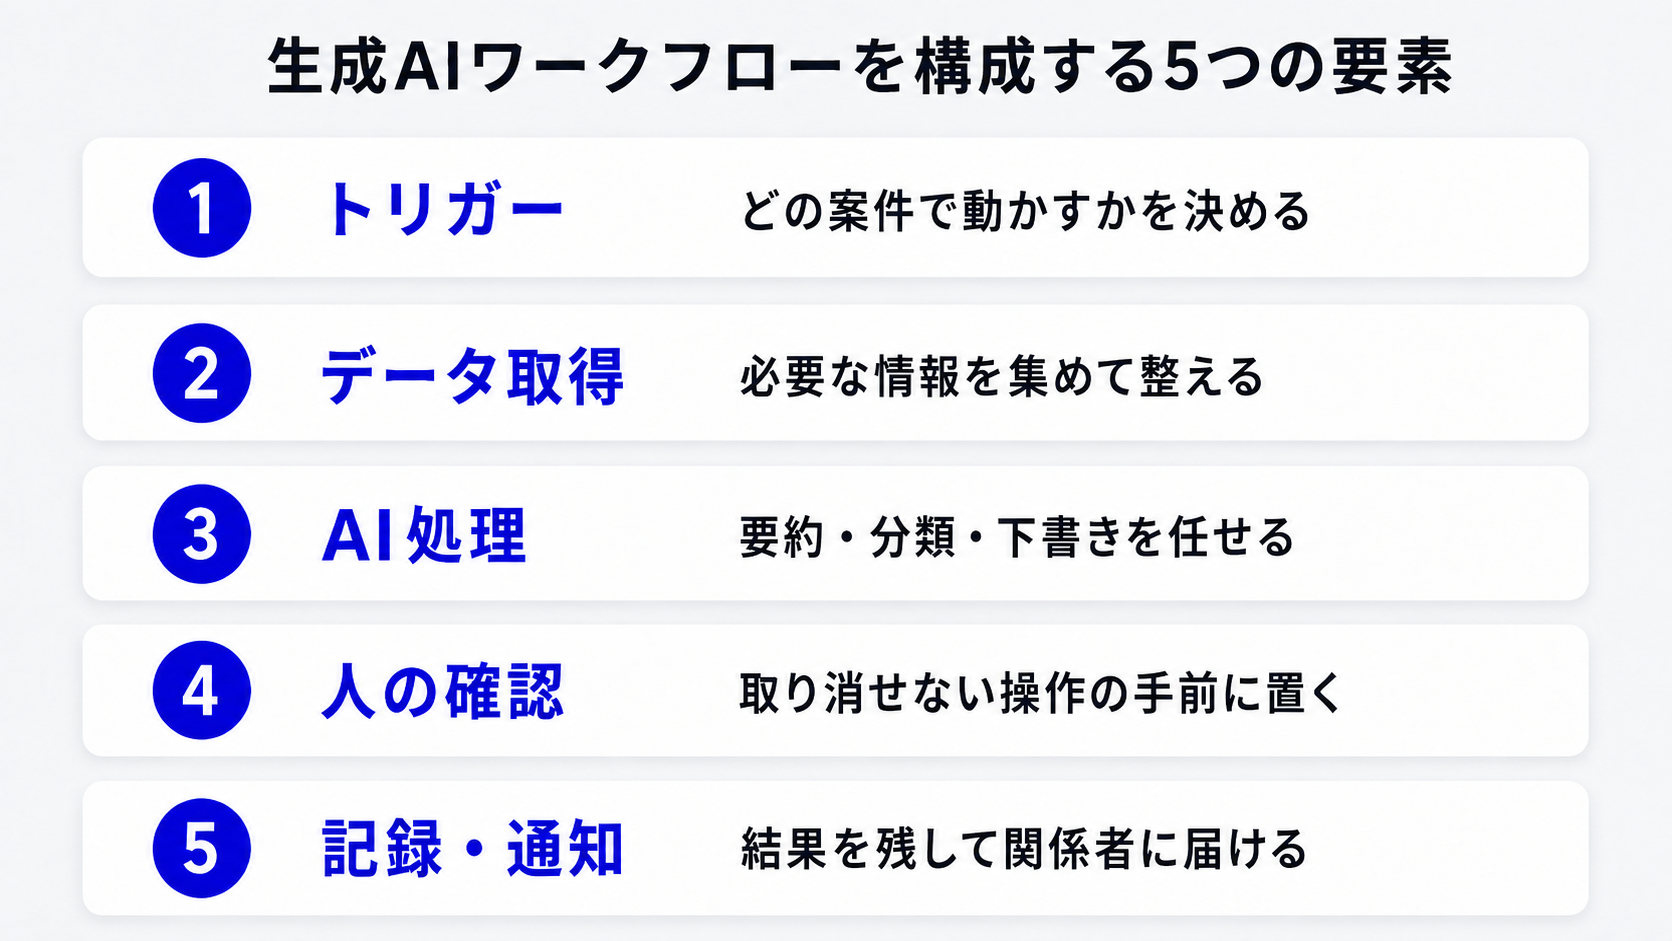
生成AIワークフローは、ツールによって画面構成や機能名が異なります。ただし、各機能を業務上の役割で捉えると、共通する5つの要素に整理可能です。
要素ごとに分ければ、回答の質が低い原因も特定しやすくなります。生成AIの性能だけでなく、入力データの不足や分岐条件、確認工程の設計に問題がないかを切り分けられるためです。
要素間の接続も共通化が進んでいます。Anthropicが2024年11月に公開したMCP(Model Context Protocol)は、生成AIと社内データや外部ツールを共通の方法で接続するためのオープンな規格です。
出典:Anthropic「Introducing the Model Context Protocol」(2024年)
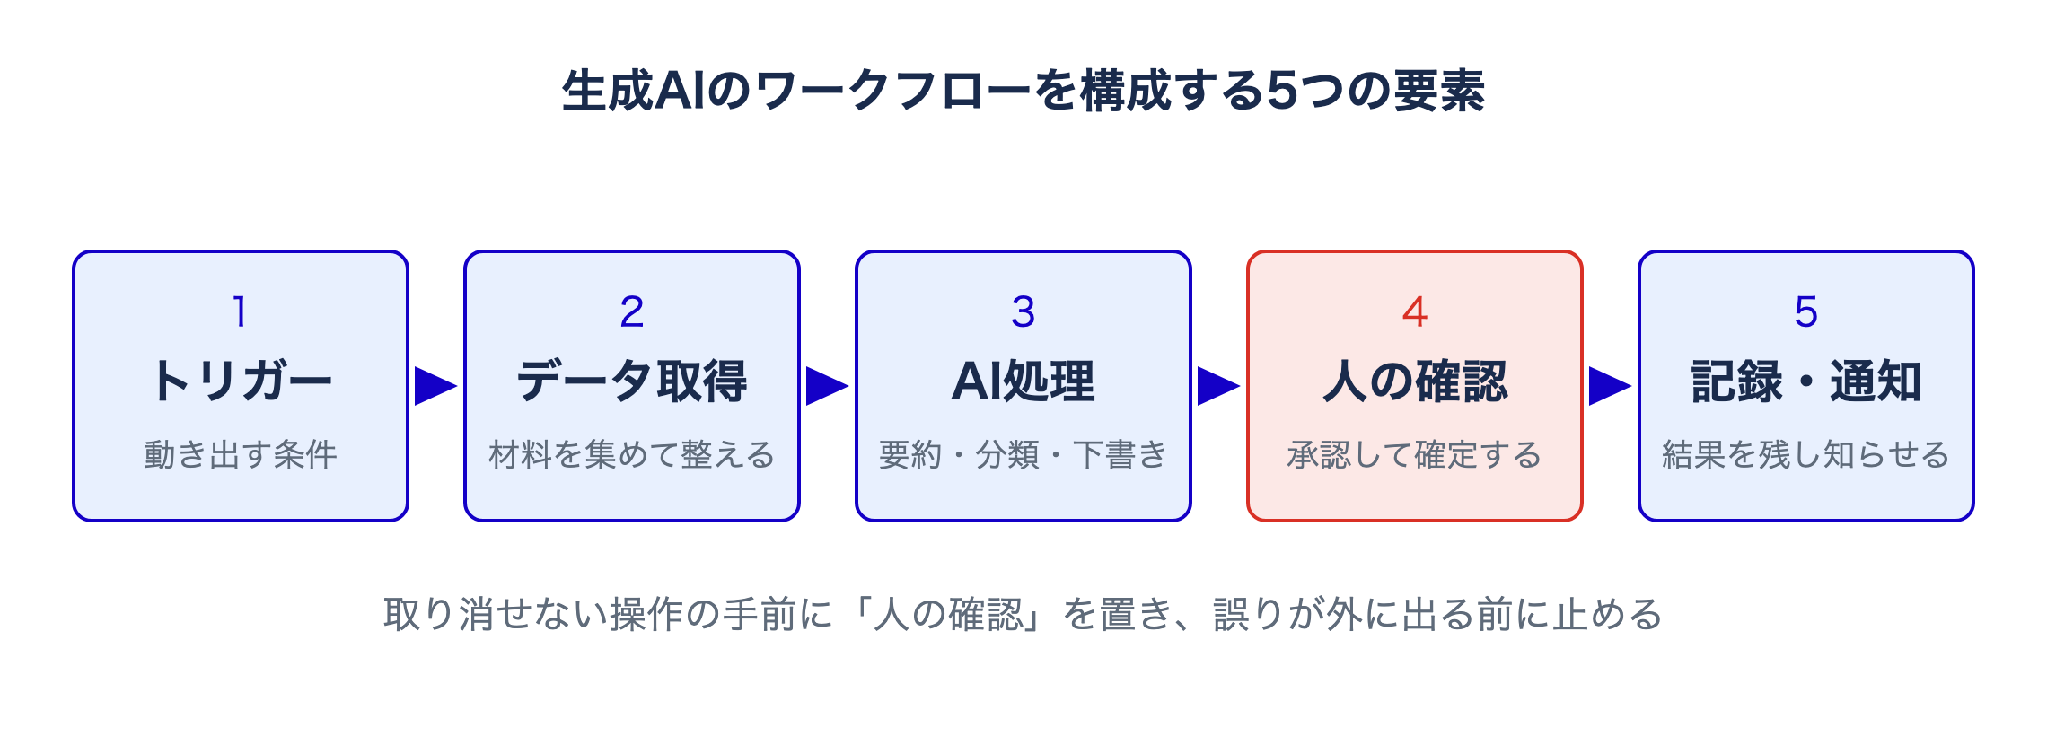
図2 生成AIのワークフローを構成する5つの要素
いつ動き出すかを決めるトリガー
トリガーは、ワークフローを正しい対象に対して動かすための開始条件です。条件が粗いと対象外の案件まで後工程へ流れ込み、人が仕分ける手間が残ります。
たとえば、問い合わせの受信やフォームの送信を合図にする場合、先に必要なのは業務担当者と対象・対象外のケースを洗い出す作業です。開始条件を具体化すれば、自動化する範囲と人が判断する範囲を明確に分けられます。
AIに渡す材料を集めて整えるデータ取得
データ取得は、生成AIの判断に必要な情報を集め、正しい材料だけを渡すための要素です。情報が不足していたり古かったりすると、生成AIが文脈を補い、事実と異なる内容を出力する可能性が高まります。
問い合わせ本文・契約情報・社内マニュアルをRAG(社内文書を検索して回答に使う仕組み)で参照する場合、渡すのは必要な範囲だけです。更新日と参照範囲を管理してからAI処理へ渡すことが、出力品質の安定につながります。
要約や下書きなどを任せるAI処理
AI処理の単位は、要約・分類・下書きといった1工程分の役割です。複数の処理を一度に指示すると、出力に誤りがあっても、どの処理に原因があるのかを特定しにくくなります。
要約した内容を次の工程で分類し、その結果から回答文を作るように分割する設計が適切です。工程と指示文を部品として固定すれば、担当者が変わっても同じ基準で処理できます。
AIの結果を人が確認して承認する工程
人の確認を置く場所は、取り消しが難しい操作の直前だけです。生成AIには、事実と異なる内容をもっともらしく出力するハルシネーションのリスクが残ります。
顧客への送信や社外への公開には承認を設け、後から修正できる社内向けの下書きは自動で流す設計が適切です。影響の大きさに応じて確認箇所を絞ることで、担当者の負担と業務の安全性を両立できます。
結果を記録して関係者に知らせる仕上げ
仕上げは、確定した結果を記録し、必要な相手へ届ける要素です。処理履歴が残らなければ、実行件数や所要時間を集計できず、導入効果や問題の発生箇所を検証できません。
正常に処理した案件は基幹システムへ登録し、判断が必要な例外だけをチャットで担当者へ知らせる運用が適切です。記録と通知の対象を分けることで、確認負担を抑えながら効果測定を続けられます。
生成AIのワークフロー活用でできること
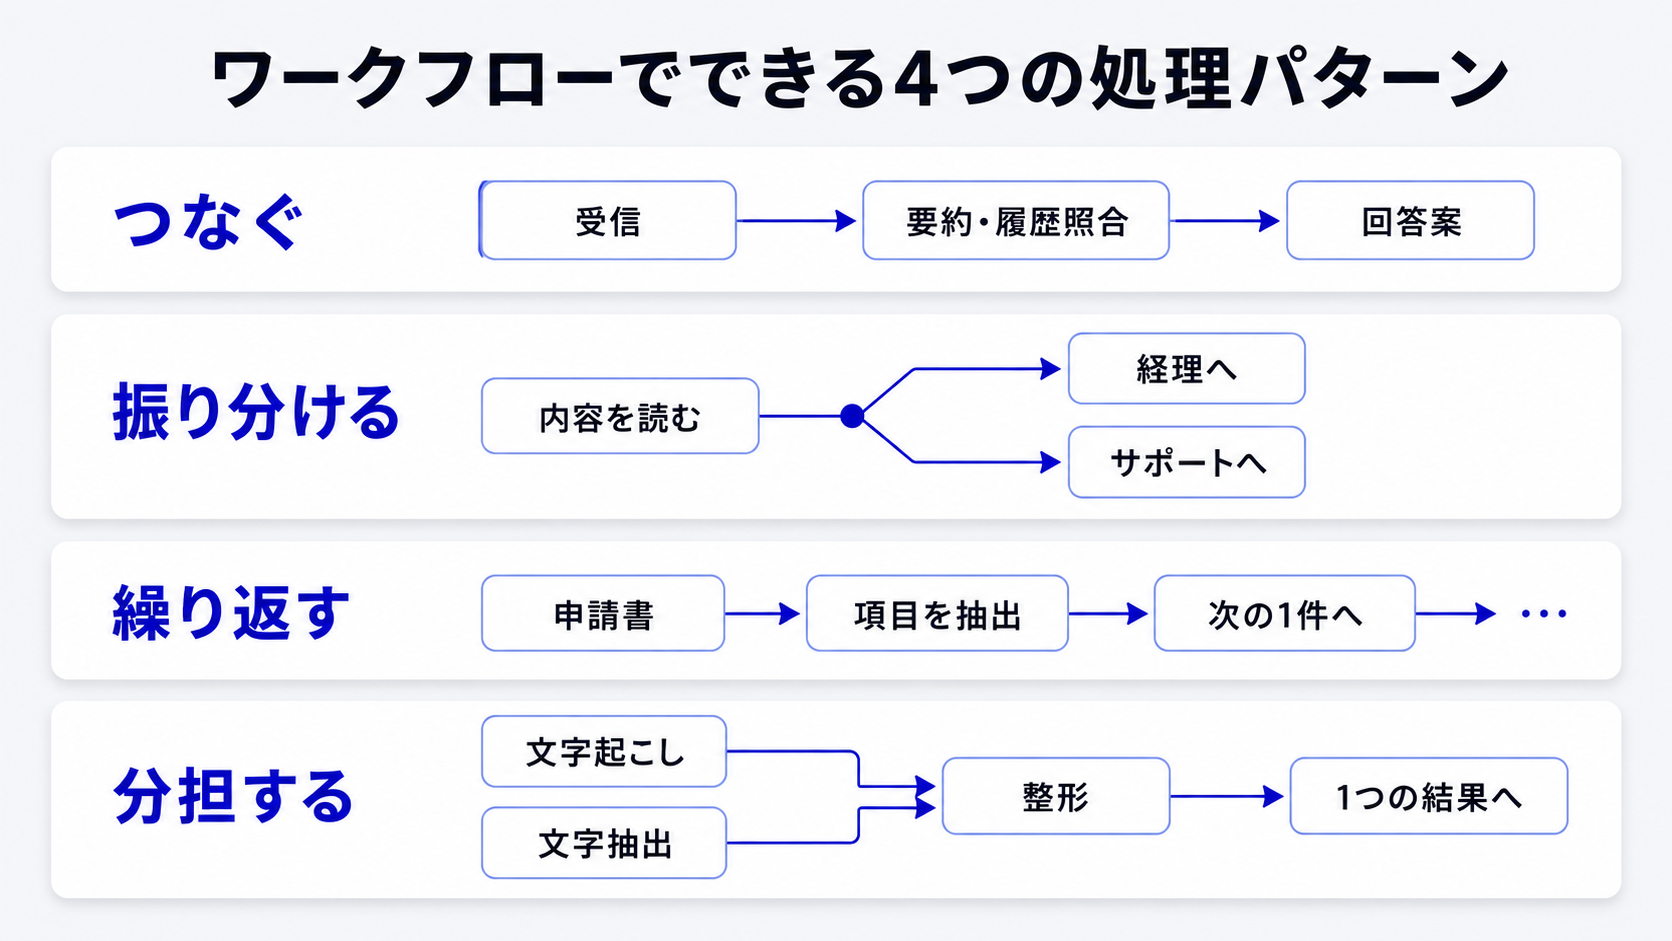
生成AIワークフローの価値は、要約や翻訳を一度行うことではなく、前後の工程とつないで反復業務を自動で進める点にあります。チャットで使うだけでは、案件ごとに人が内容を入力し、出力結果を別のシステムへ移す作業が必要です。
1件5分の作業でも、月に600件あれば合計50時間となり、操作を繰り返す負担は小さくありません。受付から要約・分類・登録・通知までをワークフローでつなぐことで、人が毎回操作せずに一連の処理を進められます。
| 観点 | 単発の生成AI利用 | 生成AIのワークフロー |
|---|---|---|
| 動かす人 | 担当者が1件ずつ操作する | 条件を満たすと自動で動く |
| 処理できる量 | 人が操作できる件数まで | 件数が増えても同じ流れで処理する |
| 工程のつながり | 工程ごとに人が受け渡す | 受け渡しまで自動でつながる |
| 内容による分岐 | 人が読んで振り分ける | 内容に応じて自動で振り分ける |
変わるのは生成AIの賢さではなく手を動かす回数で、介在が減るほど削減時間は積み上がります。
問い合わせの受信から回答案の作成までを自動でつなぐ
問い合わせ対応で減らせるのは、受信から回答案の作成までをつないだときの工程間の受け渡しです。担当者が工程ごとに着手すると、対応待ちや履歴の検索、下書きの作成に時間がかかります。
問い合わせメールの受信を起点に、要点の抽出・対応履歴の検索・回答案の作成までを自動で進める流れです。各工程をつなげれば、担当者は回答案の事実確認と送信の判断に集中できます。
内容に応じて処理の進め方を自動で振り分ける
条件分岐は、問い合わせの内容に応じて処理先や後続工程を切り替える仕組みです。キーワードだけで判定すると、同じ内容でも言い回しが変わった場合に分類から外れます。
請求は経理、不具合はサポートへ送るように、生成AIが文意を読み取って振り分ける形です。分類を3〜5種類程度に絞り、該当しない案件を人が確認する枠を設けることで、誤分類にも対応できます。
大量のデータを1件ずつ自動で処理し続ける
繰り返し処理は、件数が多く、手順が決まった業務に適した使い方です。人手では、処理できる量が担当者の作業時間に左右され、件数が増えるほど未処理の案件もたまりやすくなります。
数百件の申請書から必要項目を抽出したり、数千件の自由記述を分類したりする作業を1件ずつ流す方法です。毎日発生し、担当者が変わっても同じ手順で処理できる業務を選べば、削減時間や処理件数から効果を確認できます。
複数のAIに作業を分担させて一本の流れで処理する
複数のAIを使うときに決めるのは、どの工程をどのモデルに割り当てるかです。1つのモデルにすべての処理を任せると、出力の精度が落ちた工程を特定しにくくなります。
音声の文字起こし・画像からの文字抽出・文章の整形を、それぞれに適したモデルへ分担させる構成です。工程間で受け渡すデータの形式を固定すれば、処理を安定させながら、停止や誤りの原因も追跡できます。
エクサベース AIで知財部門の業務時間を月120時間削減
文書の読み解きと要約は、工程に組み込むほど削減時間が積み上がります。エナジーウィズは特許文献の読解や要約に「エクサベース AI」を使い、知財部門で1人あたり月間120時間を超える削減を公表しました。1万字を超える文献から必要な技術情報を取り出す作業が、数日単位から数分単位に変わっています。
出典:エクサウィザーズ「知財部門で月間120時間/人の業務削減」(2025年)
※同社公表値。効果は業務内容・利用状況により異なります。
生成AIのワークフローを作るツールは大きく4つのタイプに分かれる
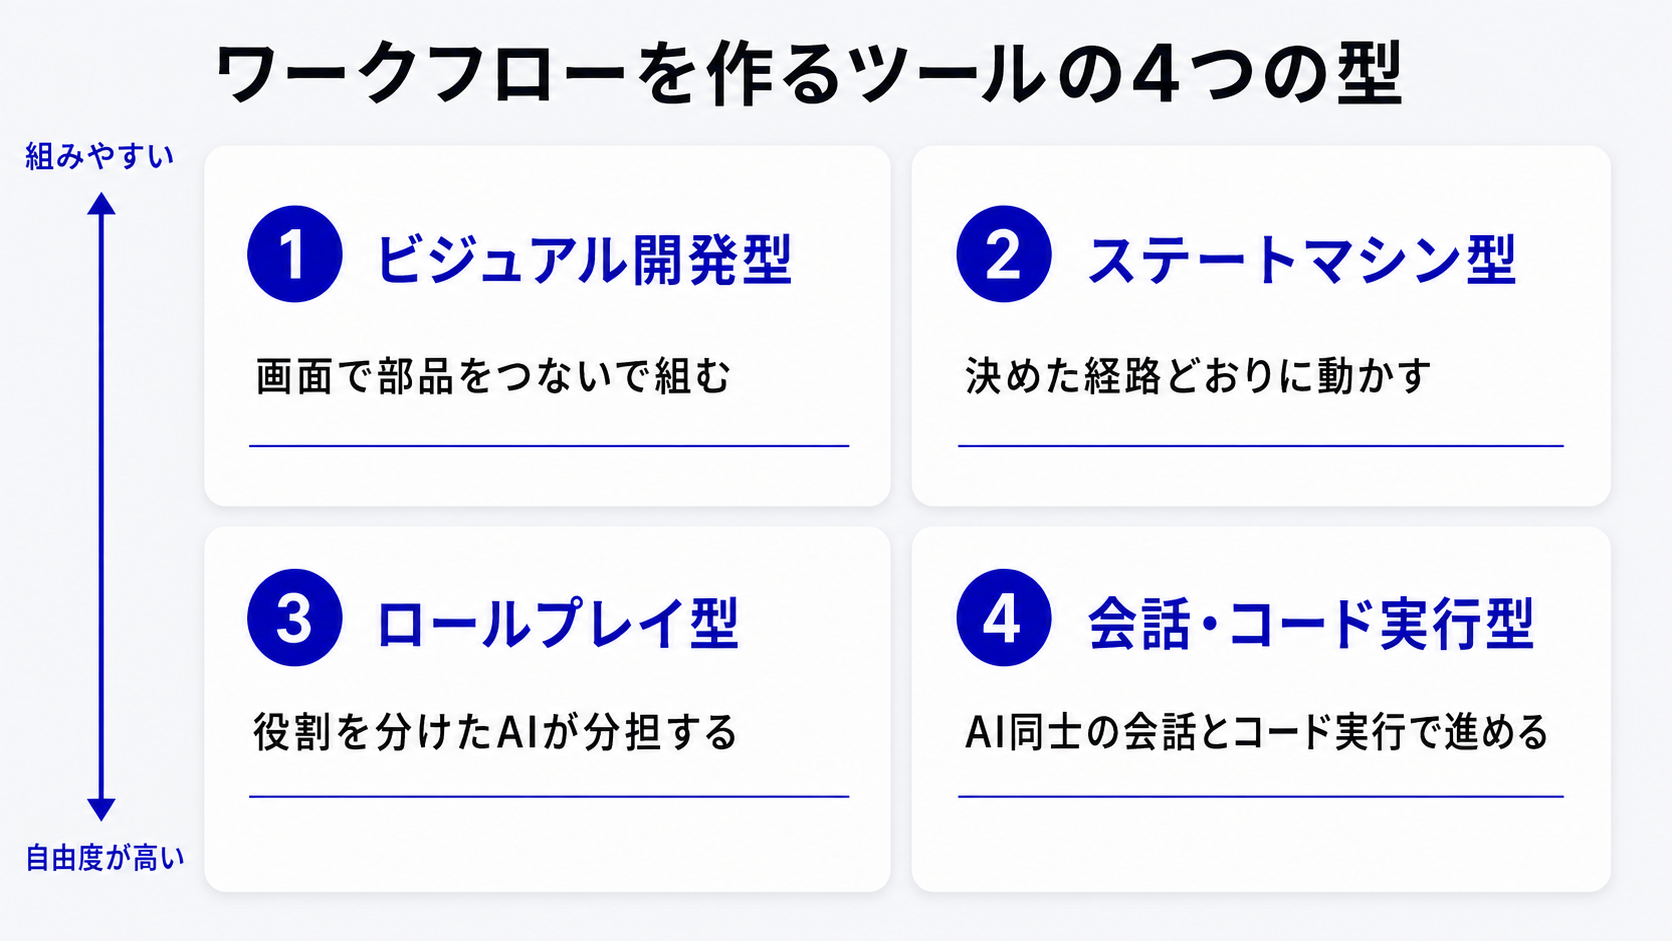
生成AIワークフローのツール選定で先に決めたいのは、機能の多さではなく、構築する人と自動化する業務の範囲です。現場担当者が画面操作で組める製品と、開発者がコードで細かく制御する基盤では、導入に必要なスキルや運用体制が異なります。
小規模な定型業務と、基幹システムをまたぐ処理では、適したツールも同じではありません。自社の目的と実装方法を対応させるため、代表的なツールを4つのタイプに分けて整理します。
| 型 | 向く場面 | 作る人 | 統制のしやすさ | 代表例 |
|---|---|---|---|---|
| ビジュアル開発型 | 画面で部品をつないで組む | 現場の担当者・情シス | 本人以外にも流れが見える | Dify |
| ステートマシン型 | 決めた手順どおり厳密に動かす | 開発者 | 通る経路を固定できる | LangGraph |
| ロールプレイ型 | 役割を与えたAIが分担する | 開発者 | 担当と権限の設計が要る | CrewAI |
| 会話・コード実行型 | AI同士の会話とコード実行で進める | 開発者・研究部門 | 実行環境の分離が前提 | AutoGen |
下へ進むほど自由度は上がり、通る経路の予測は難しくなります。
画面で組み立てるビジュアル開発型
ビジュアル開発型は、現場担当者が処理の流れを確認しながら組み立てたい場合に適した方式です。部品を画面上でつなぐため、コードだけで実装する場合よりも、処理の順序や分岐を把握しやすくなります。Difyでは、視覚的な部品と指示文を使い、データの参照・条件判断・ツールの利用などを定義できます。
出典:Dify「The Platform for Production-Ready Agentic Workflows」(2026年8月時点)
処理経路が画面に残ることで、担当者以外も内容を確認し、修正や引き継ぎを進められます。
決めた手順どおりに厳密に動かすステートマシン型
ステートマシン型は、処理の状態と次に進む経路をコードで管理する方式です。許可する経路や承認箇所を明示できるため、複雑な処理でも動作を制御しやすくなります。LangGraphは、エージェントの実行基盤と低レベルのオーケストレーション機能を提供し、状態を保ちながら制御フローを組み立てられる仕組みです。
出典:LangChain「LangGraph」(2026年8月時点)
変更時にはコードの修正が必要になるため、業務担当者と開発者が要件を共有して運用します。
役割を分担させるロールプレイ型
ロールプレイ型は、複数のAIに異なる役割を与え、作業を分担させる方式です。1つのAIに調査・分析・文章化をまとめて任せると、指示が複雑になり、問題が生じた工程も特定しにくくなります。CrewAIでは、役割・目標・背景を設定したエージェントを構成し、調査担当と文章化担当のように作業を分けられます。
少数の役割から始め、出力の受け渡しと品質を確認してから分担範囲を広げます。
AI同士が会話してコードを実行する会話・コード実行型
会話・コード実行型は、複数のAIが対話しながら、計算やデータ処理まで進める方式です。文章生成だけでは完結しない業務でも、生成したコードを実行することで必要な結果を得られます。AutoGenは、会話型の単一・複数エージェントを構築する枠組みで、モデルが生成したコードをDockerコンテナ内で動かす実行部品も備えています。
出典:Microsoft「AutoGen Documentation」(2026年8月時点)
コード実行を伴うため、実行環境・アクセス権限・停止条件を先に定めて運用します。
本番の業務では、4タイプから1つだけを選ぶ必要はありません。業務全体の経路は制御しやすい型で固定し、探索や複数AIの協調が必要な工程だけ別の型を組み合わせることで、運用の安定性と柔軟性を両立できます。
▼関連記事|【2026年最新版】Difyとは?AI開発の知識がなくても大丈夫!具体的な機能と活用シーン、活用事例を解説
▼関連記事|n8n活用事例20選|部門別の業務自動化ワークフローを紹介
生成AIのワークフローを自社に導入する進め方
ツールを選ぶ前に決めるべきことは、どの業務から手をつけるかです。導入がうまくいかない原因の多くは、製品の機能ではなく対象の選び方と体制にあります。
総務省の調査では、業務変革について「組織的な取り組みはない」と答えた日本企業は27.0%でした。米国は1.4%、ドイツは4.9%、中国は2.6%にとどまります。
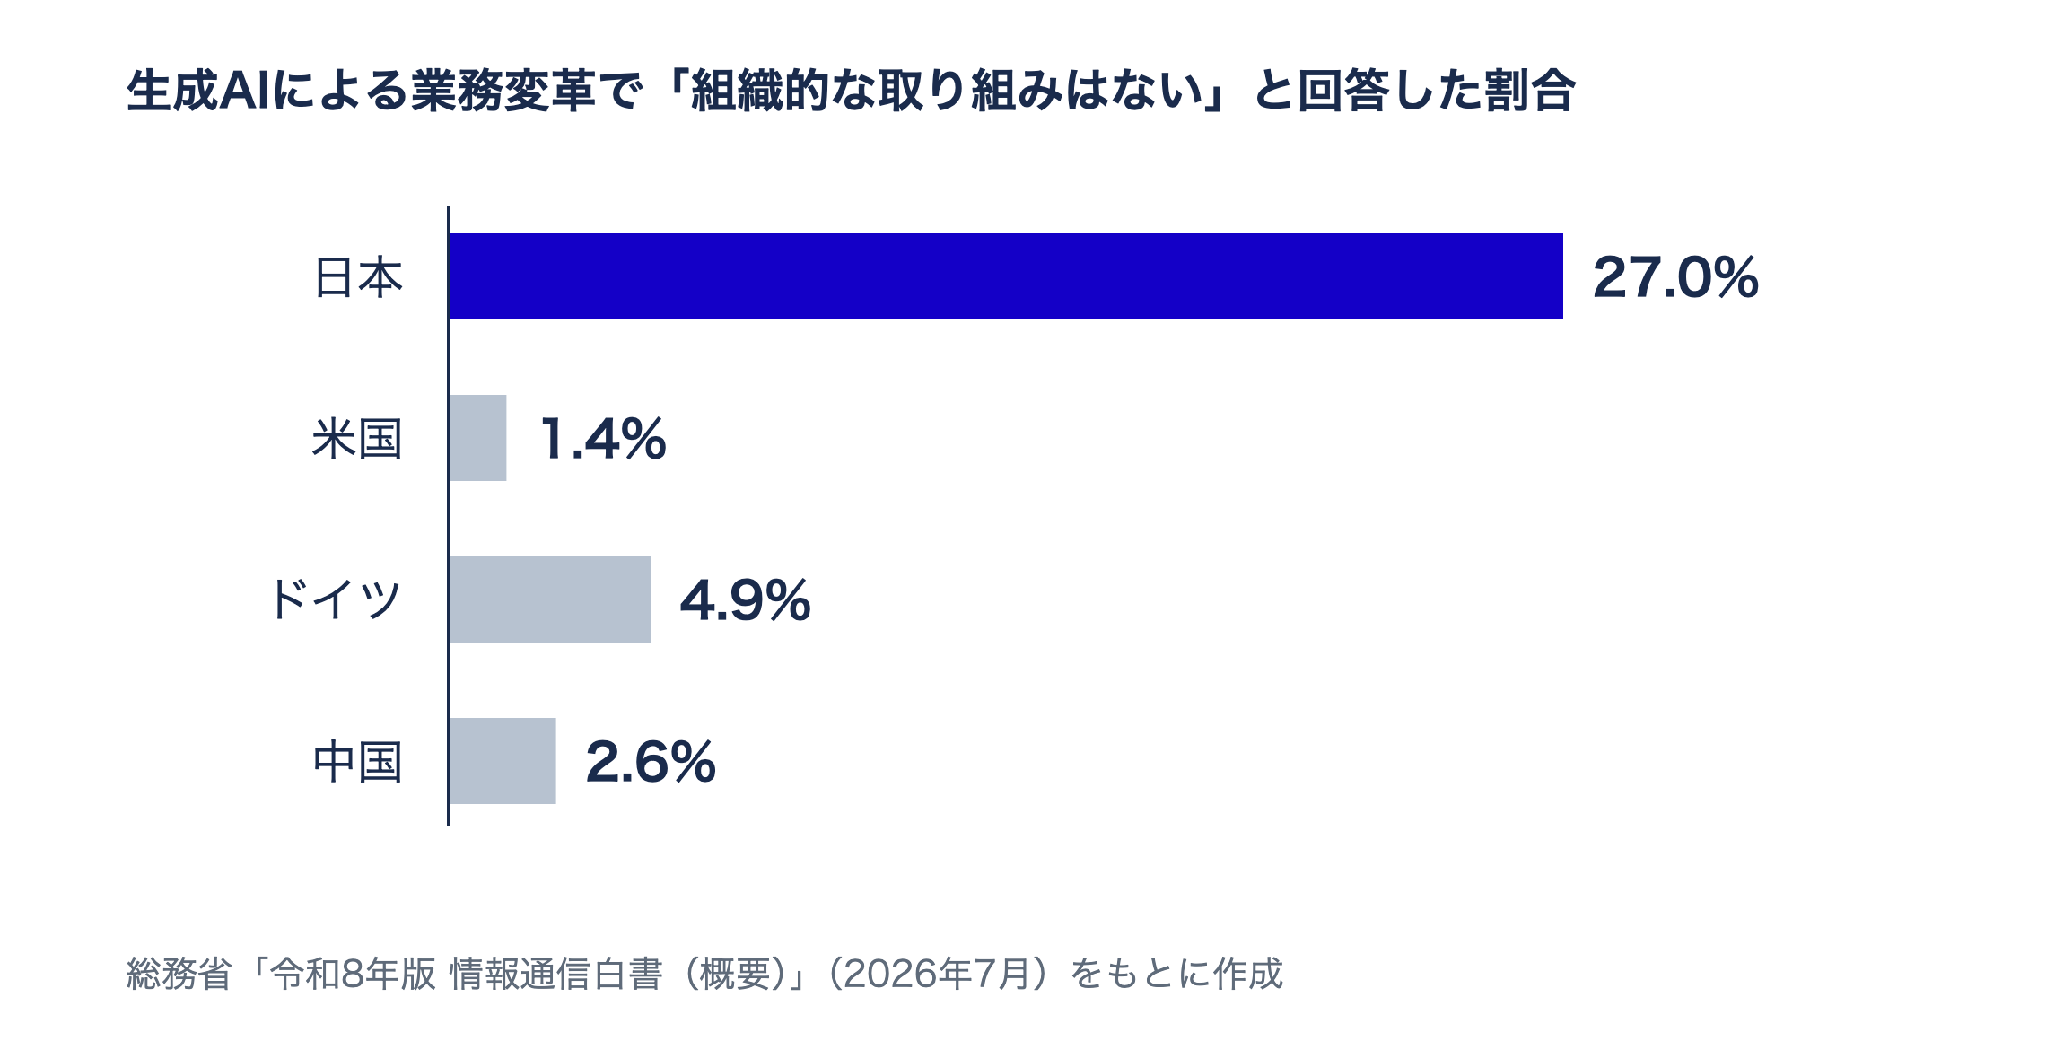
図3 生成AIによる業務変革で組織的な取り組みはないと回答した企業の割合
出典:総務省「令和8年版 情報通信白書(概要)」(2026年7月)
利用企業が8割を超える一方、約4社に1社は組織的な取り組みに至っておらず、米・独・中との差が目立ちます。
手順を決めて組織で回せるかどうかが、成果の分かれ目です。進め方は、次の5つの手順に分けて考えます。
- 1. 自動化する業務を選ぶ
- 2. AIが使う社内データを整える
- 3. 小さく試して効果を測る
- 4. 運用と保守の担当を決める
- 5. 成果が出た業務から対象を広げる
自動化する業務を選ぶ
最初に選ぶべきなのは、件数が多く、手順が決まり、判断の余地が小さい業務です。判断の多い業務から始めると確認や例外対応が増え、自動化の効果を測りにくくなります。
候補を並べる基準は月間件数と1件当たりの作業時間、比べるのは削減できる時間です。失敗しても修正できる社内工程を優先すれば、小さな影響範囲で検証を進められます。
AIが使う社内データを整える
整備するのは、選んだ業務に必要な範囲の社内データです。参照するマニュアルや対応履歴が古いままでは、AIも更新前の情報に基づいて回答します。
対象業務で使う文書に限定したうえで決めるのは、最新版の判定基準・更新担当・アクセス権限の3点です。個人情報を含むプロンプトは、特定した利用目的の達成に必要な範囲かを確認するよう、個人情報保護委員会も求めています。
出典:個人情報保護委員会「生成AIサービスの利用に関する注意喚起等について」(2023年6月)
小さく試して効果を測る
試験導入で先に決めておくのは、合否を判断する指標です。導入前の数値がなければ、処理が速くなっても、自動化による効果かどうかを判断できません。
試験の単位は1つの部署の1業務、期間は1〜2カ月、導入前と比べる数字は対応時間・処理件数・差し戻し件数です。Anthropicは最も単純な解決策から始めることを勧め、Google Cloudも開発初期は単一エージェントから始めるよう推奨しています。
運用と保守の担当を決める
試験導入の段階で決めておきたいのは、運用と保守を担う担当者です。参照文書や承認経路が変わるたびにワークフローの修正が必要となり、担当者が不明確では更新が止まります。
必要なのは、業務上の判断を担う責任者、処理の流れを修正する担当者、権限とデータを管理する情報システム部門の3者です。兼任でも役割と連絡先を明確にすれば、業務の変更に合わせて運用を続けられます。
成果が出た業務から対象を広げる
展開の起点になるのは、削減時間や処理件数で効果を確認できた業務です。最初から全社展開すると、部署ごとに異なる手順や例外への対応が増え、改善すべき箇所を特定しにくくなります。
広げる順序は、同じ部署の隣接業務が先、同じ業務を持つ別の部署が後です。処理件数・削減時間・差し戻し件数を記録しておけば、追加導入の判断や次の部署への説明も進めやすくなります。
全社へ展開する段階では、利用状況の把握とアクセス権限の管理が新たな課題です。複数部署の利用を一元管理しながら展開する場合は、法人向けの「エクサベース AI」が選択肢になります。
生成AIのワークフロー導入で注意すべき点
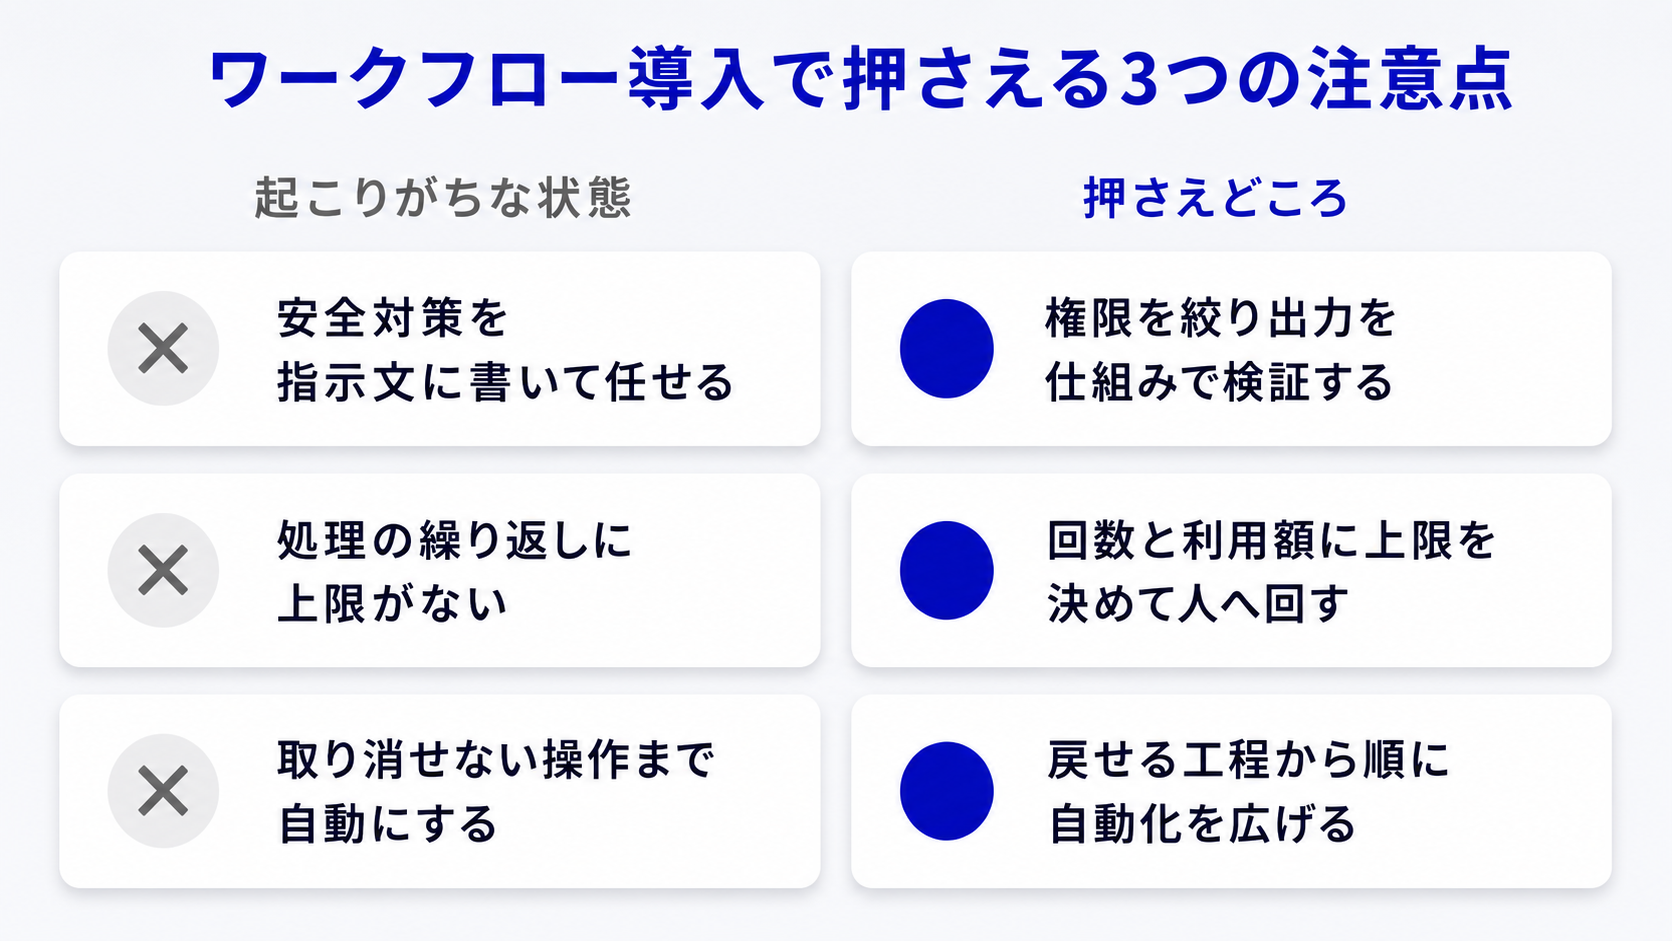
動き出したあとのワークフローは、人の目が届きにくい仕組みです。自動で流れる範囲が広いほど、設計時の見落としも同じ回数だけ繰り返されます。決裁に関わる立場で押さえておきたい点を、3つに絞りました。
- 安全の仕組みを指示文だけに任せない
- 処理が止まらずに利用料が膨らむ形を防ぐ
- 最初から完全な自動化を目指さない
プロンプトに安全対策を任せない
安全対策の軸になるのは、プロンプトの書き方ではなく、システム側の権限・検証・承認です。外部文書に別の指示が含まれると、モデルがその内容を処理し、意図しない出力や操作につながる場合があります。OWASPがプロンプトインジェクションへの主な対策として示すのは、最小権限・コードによる出力形式の検証・高リスク操作に対する人の承認です。
出典:OWASP「LLM01:2025 Prompt Injection」(2025年)
Anthropicも、応答を作るモデルと不適切な内容を検査するモデルを分ける構成を示しています。
出典:Anthropic「Building effective agents」(2024年)
プロンプトは防御の一部と捉え、モデルの外側に複数の制御を設ける設計が必要です。
勝手な思考ループによるAPI費用の消費を防ぐ
費用を管理するには、1回の処理で許す繰り返し回数と利用額に上限を設けます。モデルが手順を決める構成では、ツールの呼び出しや再試行のたびに待ち時間と利用料が増える構造です。Anthropicも、エージェントの自律性には高い費用と誤りが重なる可能性が伴うと説明し、最大反復回数などの停止条件を示しています。
出典:Anthropic「Building effective agents」(2024年)
繰り返し回数・処理時間・月間利用額のいずれかが上限に達した時点で、続きを引き取るのは人です。
はじめから完全に自動化しない
初期段階では、失敗しても元に戻せる工程だけを自動化します。送信・決済・データの書き換えまで一度に任せると、誤りが起きた際の復旧が難しく、影響範囲も広がるためです。
差し戻しの件数と理由を1〜3カ月記録し、誤りが起きる条件と修正方法を確認します。人の承認を外すのは、差し戻しが少なく、発生した問題への対策を確認できた工程からです。
機密情報を守りながら社内データで生成AIを使うなら
社内の文書や顧客情報を工程に組み込むほど、データの置き場所と権限の管理が前提条件です。「エクサベース AI」は、社内の独自データを参照する回答生成に対応します。IPアドレス制限とログ記録、国内サーバーでの処理、入力情報を学習へ提供しない設定も備えました。
出典:エクサウィザーズ「エクサベース AI」(2026年8月時点)
生成AIのワークフローの活用事例
既存の手順の中へ生成AIを組み込み、成果を公表している取り組みを2つ紹介します。
スタディサプリが3つのAIをつなぎ講義動画の字幕生成を自動化
スタディサプリが自動化したのは、講義動画に字幕をつける工程です。音声認識のWhisper、教材PDFから数式を含む文字を読み取るOCR、文章を校正するGeminiの3つを1本のワークフローにつないでいます。OCRと字幕生成を並列で走らせ、両方が終わったあとにGeminiが校正する順序を、処理の依存関係として定義しました。以前は開発者が自分のパソコンでスクリプトを手動実行しており、対象講座を広げる段階で自動化に踏み切っています。
出典:スタディサプリ Product Team Blog「Argo Workflows で構築する、生成 AI 字幕生成ワークフロー」(2026年1月)
性質の違う処理を得意なモデルへ割り当てたことが、失敗した工程だけをやり直せる設計につながりました。
カカクコムがDifyの全社導入で約70のAI業務アプリを内製
カカクコムが取り組んだのは、AIアプリを現場の社員がつくれる環境の整備です。Difyのエンタープライズ版を全社に導入し、言語モデルと指示文の管理を1か所にまとめています。背景にあったのは、エンジニア以外が作れない、試作から本番まで時間がかかる、管理が部署ごとに分散するという3点でした。社内アンケートでは全従業員の約3割がアカウントを登録し、作成されたアプリは約70個に達したと報告されています。
出典:カカクコム Tabelog Tech Blog「カカクコムにおけるDifyエンタープライズ版の全社導入と活用ポイント」(2025年5月)
回答者の約8割が、ほぼ毎日または週に2〜3回利用していると答えました。
生成AIのワークフローを安全に運用する選択肢はエクサベース AI
ここまでの仕組みと注意点をふまえると、社内でワークフローを回すのに必要な条件は3つです。社内データを参照できること、だれが何に使ったかを追えること、入力情報がモデルの学習に利用されない形で処理されることになります。
エクサベース AIが備える社内データ活用と統制の機能
エクサベース AIは、法人での利用を前提に設計された生成AIサービスです。社内の独自データを参照して回答を生成する機能を備え、IPアドレス制限とログ記録で利用状況を管理できます。データ処理は国内サーバーで行われ、入力した情報はモデルの学習へ提供されません。
繰り返し作業を自動化するAIエージェントの機能も用意されています。ISO27001、ISO27017、ISO27701の認証を取得し、導入企業は2,000社、利用ユーザーは18万IDに達しました(※2026年11月時点)。
出典:エクサウィザーズ「エクサベース AI」(2026年11月時点)
エクサベース AIの導入で業務時間を削減した事例
参考になるのは、公表されている削減時間の実績です。金沢市は2024年8月に自治体向けのエクサベース AIを全庁で導入し、2024年度下半期の削減効果として3,216時間を公表しています。内訳は、文書業務の要約・原稿作成・レビューで2,298時間、コード作成業務で918時間でした。
出典:エクサウィザーズ「半期の削減効果は3,216時間 LGWAN対応だから実現できた、シームレスな生成AI活用」(2025年)
まとめ
生成AIのワークフローは、業務の手順に生成AIの処理を差し込み、受け渡しまで自動でつなぐ仕組みです。工程の連鎖・条件分岐・繰り返し・分担という形で、単発の利用では届かない効果が積み上がります。
導入で守りたい順序は、対象業務を選び、データを整え、小さく試して数字で確かめることです。取り消せない操作の手前に人の確認を残し、安全の制御を指示文だけに任せない形にします。
自社のどの業務から組み込み、どう効果を測ればよいかを検討したい場合は、サービス資料をご覧ください。
※ 料金やモデルの仕様、利用上限などの最新情報は変更される可能性があるため、導入検討の際は必ず各サービスの公式ウェブサイトにて最新の金額・情報をご確認ください。
※ 記載されている会社名、製品・サービス名は、各社の登録商標または商標です。