「AstraはまだAGIではない」 評価団体が反論


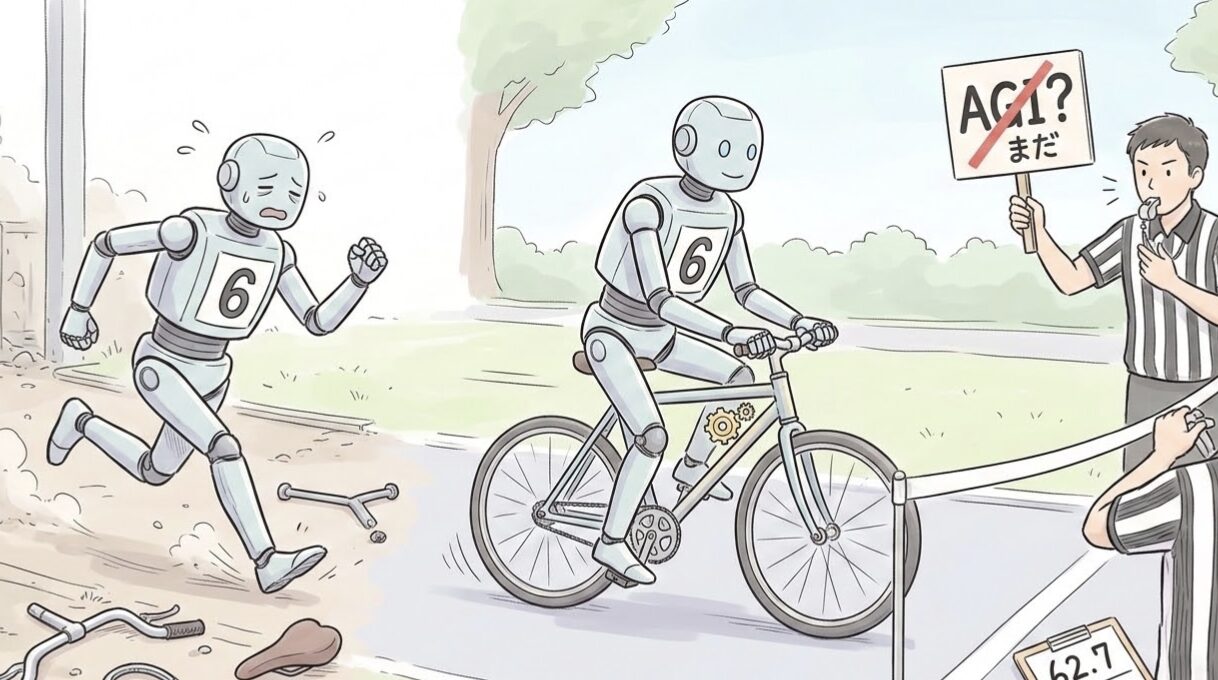
米OpenAIが「AGI(汎用人工知能)の時代に入った」と宣言した同社の最新モデル「GPT-6 Astra」について、AGI測定用のベンチマーク(評価テスト)「ARC-AGI-3」を運用する米ARC Prize財団が「AGIとは言えない」と異論を表明し、議論になっている。OpenAIが宣言の根拠の一つとした「ARC-AGI-3で99.9%」という数字も、ARC側が中立的な条件で測ると62.7%。宣言を支える土台そのものが揺れている。
「AGIの時代へようこそ」
OpenAIは9月3日、Astraを「世界で最も知的で、最も整合したモデル」として発表した。発表文は「ARC-AGI-3で99.9%」とほぼ満点の成績を掲げ、記者向け説明会でGreg Brockman社長は「個人的には、もう到達したと思う」と述べ、「Welcome to the AGI era(AGIの時代へようこそ)」と締めくくった。
ARC-AGI-3は、説明のない未知のゲーム環境にAIを放り込み、ルールを探索し、目標を推測し、計画を立てて解かせるテストだ。記憶した知識では解けないため、「AIと人間の残された差」を測る指標として引用されてきた。ここで99.9%という数字が出れば、AGI宣言につながるのは自然な流れだった。
ARC側「満点でもAGIの証明ではない」
同じ9月3日、ARC Prizeは自前の検証結果を公開した。Astraの進歩そのものは高く評価しており、「フロンティアモデルの能力の段差的な変化」と呼び、祝うべき節目だとする。一般人約500人を測って作った基準より少ない操作回数で96%のレベルを解き、操作回数は平均51.7%少なかった。少ない試行で解法にたどり着く効率で、人間並みに達したと認めている。
ただしAGIかどうかについては、はっきりと否定した。「このテストで満点を取ってもAGI達成の証明にはならない」と発足時から明記していたと念を押し、「Astraは意味ある前進だが、AGIとは言えない」との立場だ。ARC-AGI-3はあくまでルールも正解も決まったパズルであり、正解のない問題に自ら答えを作り出す現実世界の複雑さは測っていない、という理由だ。共同創設者のMike Knoop氏もXで「AGIと呼ぶ証拠はまだない。誰も答えを知らない問題を自力で切り開く力は、まだ実現していない」と投稿した。
同じモデル、37ポイントの差
ARC側が問題視するのは、99.9%という数字がどんな条件で測られたかだ。ARC Prizeは結果を2種類の条件で公開した。ARC側の「標準ハーネス」では62.7%。OpenAIの仕組みを使う「プロバイダー・アダプター」ハーネスでは99.9%。
ハーネスとは、モデルの周囲を包む試験用ソフトウェアのことだ。モデルがどんな道具を使えるか、やり取りの合間に何を覚えていられるかを決める。標準ハーネスはどの社のモデルにも同じ条件を課す簡素な仕組みで、ゲームを1回操作するごとにやり取りが区切られ、次のやり取りに持ち越せるのはモデルが自分で書き残したメモだけになる。一方のプロバイダー・アダプターはOpenAIのAPIの機能を使い、メモだけでなく、モデルが頭の中で考えていた途中経過もそのまま次のやり取りに引き継げる。ゲームが長引いても、それまでの経緯を自動で要約して覚えておく。人間で言えば、1手ごとに記憶を消されながら解くのが標準ハーネス、考えを途切れさせずに続けられるのがアダプターだ。同じモデル、同じ問題で、37ポイントの差がついた。
周囲の仕組みがどれほど効いたかを示す数字がある。モデルにはじっくり考えさせる設定と、ほとんど考えさせない設定がある。アダプターを使えば、ほとんど考えさせない設定でも96.7%。標準ハーネスで最もじっくり考えさせた62.7%を、34ポイントも上回った。モデルにどれだけ考えさせるかより、記憶を引き継げるかどうかの方が、点数を大きく左右したことになる。
ARC Prizeは、2つの数字は測っているものが違うと説明する。標準ハーネスの62.7%は、各社のモデルを同じ条件に置いて横並びで比べた数字だ。ARC側は、本物のAGIならこの条件で解けるべきだと考えている。アダプターの99.9%は、OpenAIが自社モデル向けに用意した補助機能を使わせた場合に、どこまで行けるかを示す数字で、他社のモデルとの比較には使えない。今後は成績表に両方の数字を、条件を明記して並べるという。
「モデルの実力ではない」のか
99.9%はモデルの実力ではなく、周囲の仕組みの手柄だ。そう見る論者は多い。AI研究者のRohan Paul氏はXで「同じモデルで37ポイントも動くのは、ARCがモデルよりハーネスを測っている最も明白な証拠だ」と投稿した。蘭テックメディアTNWは9月6日の検証記事で、99.9%を出したのはモデルと周辺の仕組みを組み合わせたシステムであり、争点はモデルの性能だ、と区別を強調した。
だが、モデルとハーネスを切り分けること自体に意味があるのか、という議論も起きている。
ARC Prize社長のGreg Kamradt氏はXで、Astra以前から複数の研究グループが独自のハーネスを組んで90%超を出していたと指摘した。米半導体大手NVIDIAのエージェント基盤に載せたClaude Opus 5は、単体の30.2%から公開問題の全問正解まで上がった例もある。ハーネスで点数が跳ねるのは今回が初めてではない。Astraが違うのは、ハーネスをほとんど使わずに62.7%に達し、OpenAI純正の記憶引き継ぎ機能を足しただけで99.9%になった点だ。周囲の仕組みが解いたのではなく、モデルが考えたことを忘れずにいられれば解ける、ということになる。
人間はどんな条件で受験したか
もう一つ、見落とされがちな点がある。ARC-AGI-3の人間の基準は、一般の被験者が普通に記憶を保ったままゲームを解いた結果だ。標準ハーネスはモデルに対し、1手ごとにメモ以外の記憶を消すという、人間より厳しい条件を課している。人間の受験条件に近いのは、むしろアダプターの方だ。
ARC側が標準ハーネスを重視する理由は「各社のモデルを同じ条件で比べるため」であり、知能の定義から出てきた理由ではない。横並びの比較としては正しいが、「AGIに達したかどうか」の判定に使う条件としては、標準ハーネスの方が不自然だという反論は成り立つ。
ただし、この反論が通ったとしても、ARC Prizeの「AGIとは言えない」という結論は揺るがない。ARC側はAGIを「人間ができるどんな技能も、人間と同じ効率で身につけられるシステム」と定義しており、モデル単体で見るべきだとは言っていない。ARC側の主張は明快だ。ARC-AGI-3で高得点を取ったからといって、それだけでAGIとは呼べない。ARC-AGI-3はあらかじめ正解が用意されたパズルであり、現実の仕事には正解の用意されていない問題の方が多いからだ。次世代のARC-AGI-4は2027年初めの予定で、正解の決まっていない問題を扱う方向を探るという。
99.9%か62.7%か、という数字の争いの裏で、問いは「モデルは考えているか」から「その考える力は、どこまで長く、広く、答えのない問題に通用するか」へと移っている。