ロボットに世界モデルは必須か Google DeepMind「まだ勝ち筋は固まっていない」


人型ロボットが人間のように動き、複雑な作業をこなすには、「今、目の前で何が起きているか」を理解するだけで十分なのか。それとも、「この動きをしたら数秒後に何が起きるか」をあらかじめ予測する能力が必要なのか。
この問いを巡り、ロボットAIの研究者の間で意見が分かれている。
米Google DeepMindでGemini RoboticsのResearch Leadを務めるKeerthana Gopalakrishnan氏は、ポッドキャスト「The Cognitive Revolution」に出演し、世界モデルは有力な研究方向の一つだとしながらも、ロボットAIに不可欠かどうかはまだ判断できないとの見方を示した。
現在のロボティクスはまだ初期段階にあり、どの方式が最終的な主流になるのかは分からない。Gopalakrishnan氏は、研究者として重要なのは特定の手法にこだわることではなく、最終的に問題を解ける方法を選ぶことだと説明している。
世界モデルで「未来を先読み」する
議論のきっかけになったのは、米半導体大手NVIDIAのロボティクス研究者Jim Fan氏の主張だった。
インタビュアーはFan氏の考えとして、ロボットAIには将来を先読みする「forward-looking simulation」が必要になるという見方を紹介した。
現在のロボットAIでは、目の前の状況を見て、考え、行動し、その結果をもう一度見て次の行動を決めるというループを繰り返す方式が多い。しかし、この方式では基本的に「現在」に反応し続けることになる。
Fan氏が重視しているのは、行動する前に、その結果として世界がどう変化するかを内部で予測する能力だ。
例えば、テーブルの上にあるコップを取ろうとするとき、人間は手を動かし始める前から、手がどのような軌道を通り、どこでコップに触れ、どの程度の力をかければ倒さずにつかめるかをある程度予測している。実際の動きと予測とのずれを見ながら、次の動作を修正する。
こうした「未来のシミュレーション」と密接に関係するのが世界モデルだ。AIが現実世界の仕組みを内部にモデル化し、自分の行動によって周囲がどう変化するかを予測する。
インタビュアーは、現在の状況を見て一手ずつ反応するだけでは、人間のように滑らかに物理世界で動くのは難しいのではないかとGopalakrishnan氏に問いかけた。
Google DeepMindは「世界モデル必須論」に乗らず
Gopalakrishnan氏は、世界モデルをロボットAIにとって非常に興味深い研究領域だと評価している。ただ、それが最終的な正解になるとは断定していない。
その背景には、LLMの成功がある。
現在のLLMは、明示的な世界モデルを別に持たなくても、次のトークンを予測する学習を大規模化することで、推論や計画、コーディングなど予想以上に高度な能力を獲得してきた。ロボットでも、大規模なVLA(Vision-Language-Action)モデルを発展させれば、世界モデルを別に用意しなくても、高度な物理的知能が生まれる可能性はある。
一方、物理世界にはLLMとは異なる問題がある。
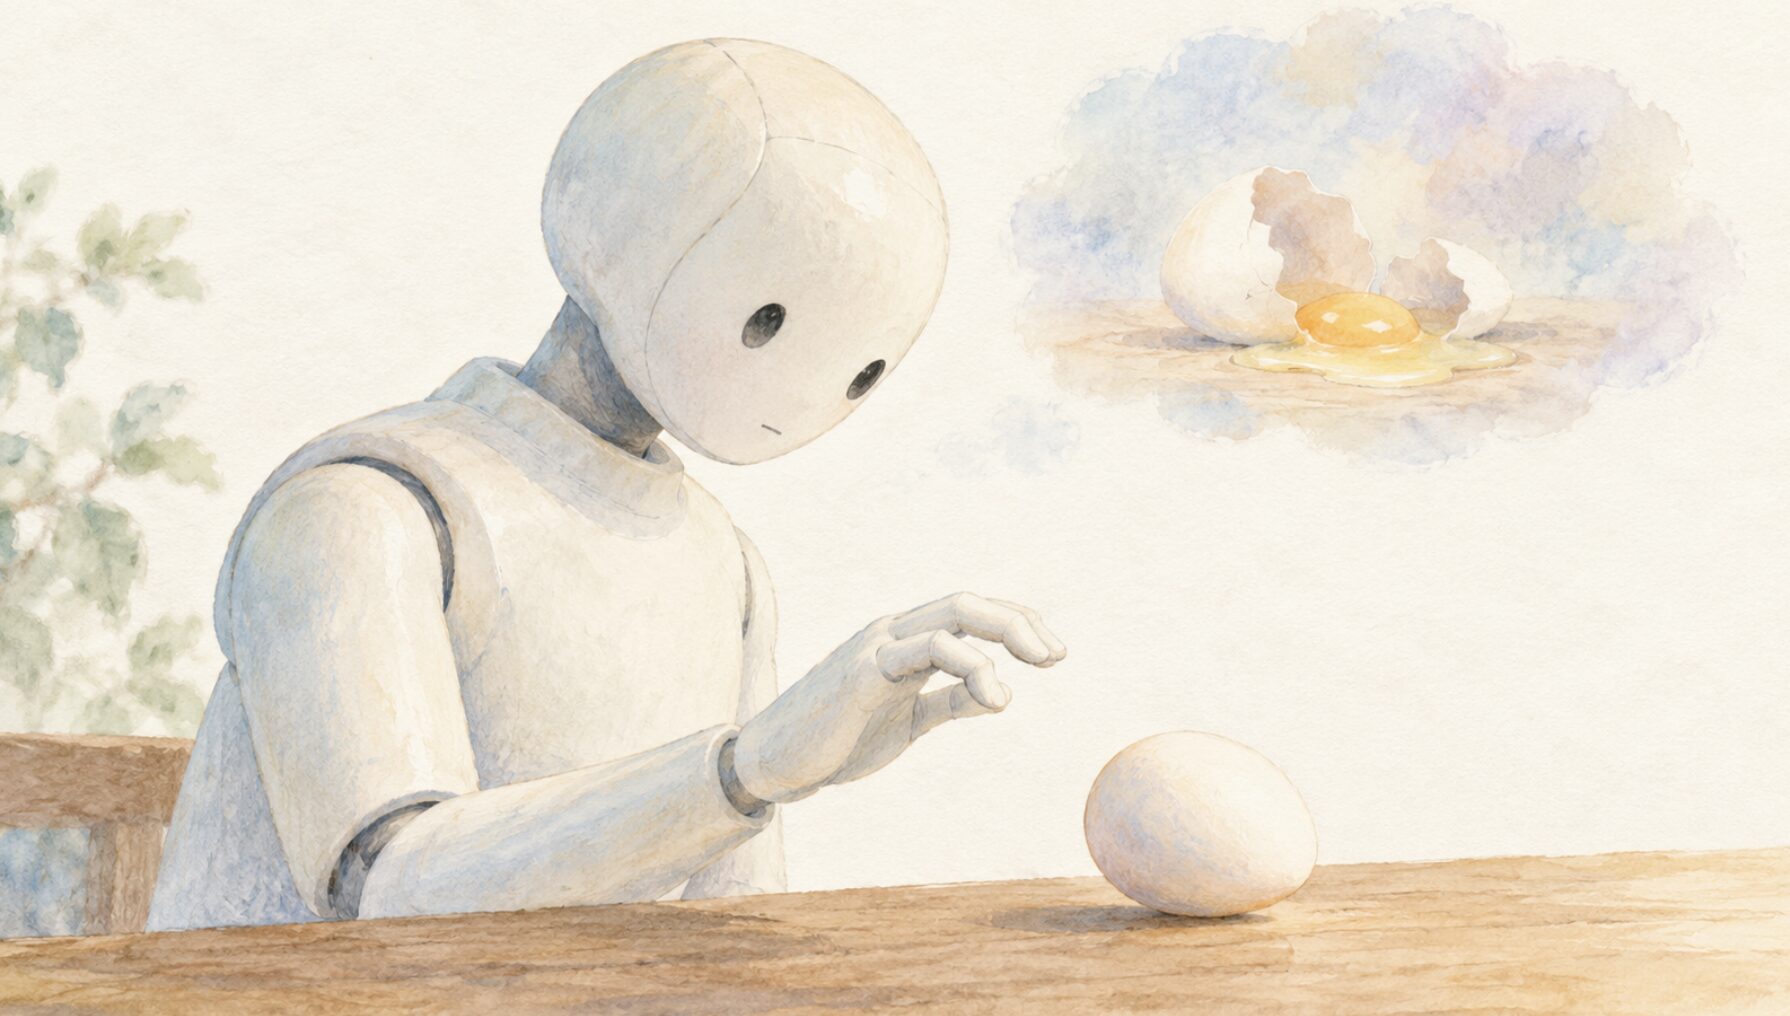
テキスト生成なら、一度間違えてもその後の出力で修正できることが多い。だがロボットの場合、卵を床に落としたり、壊れやすい物を強くつかんだりすれば、その失敗を簡単には巻き戻せない。
Gopalakrishnan氏も、Legoの組み立てなら間違っても戻ってやり直せるが、卵を床に落としてしまえばそうはいかないと説明している。
行動をやり直せない場面が多い物理世界では、実際に動く前に結果を予測する能力が重要になる可能性は十分にある。ただ、それを独立した世界モデルとして実装することが最善なのか、VLAの大規模化など別の方法で獲得できるのかは、まだ決着していない。
ロボットAIは「まだGPT-2」
Gopalakrishnan氏が世界モデルについて結論を急がない背景には、ロボットAIそのものがまだ初期段階にあるという認識もある。
インタビュアーから、現在のロボティクスをLLMの進歩になぞらえるとどこに位置するかと聞かれ、同氏は「まだGPT-2だと思います」(I think still GPT-2.)と答えた。
理由の一つは、少数の事例から新しい作業を覚えるfew-shot learningが、多種多様なタスクで十分に機能していないことだ。もう一つがcross-embodiment、つまり一つの身体で学んだ知能を別のロボットへ移す問題がまだ解決していないことだ。
GPTならスマートフォンでもMacでもLinuxでも、基本的には同じような能力を期待できる。ところがロボットAIでは、ある人型ロボットで機能したモデルを、別の身体へ載せただけでは同じように動かない。
Google DeepMindが目指しているのは、特定の機体専用のAIではなく、さまざまなロボットで使える共通の知能だ。Gopalakrishnan氏は、特定の一つの身体専用の頭脳を作っているわけではなく、知能を最終的な身体の形からある程度切り離す方向で研究していると説明している。
ただし、この考え方がすでに実現したわけではない。まったく新しい身体へモデルを載せ、追加学習なしで多くのタスクを高い信頼性でこなす段階にはまだ達していない。
データについても「勝者」はまだ決まっていない
ロボットAIの勝ち筋が定まっていないのは、モデルの構造だけではない。何を学習データの中心にするかについても意見が分かれている。
インタビュアーはFan氏の考えとして、将来は人間が見ている一人称動画が主要な学習データとなり、さらにその先ではシミュレーションが中心になるという予測を紹介した。
Gopalakrishnan氏は、こうした予測よりも実験結果を重視する姿勢を示した。現時点では、最終的に一種類のデータへ収束するというより、複数のデータを組み合わせる可能性が高いと見ている。
例えば、人間が実際のロボットを遠隔操作するteleoperationのデータは、ロボットの動作を直接記録するため精度が高い。ただし大量に集めるのが難しく、ロボット本体の設計が変われば、古い身体で集めたデータの価値も下がる。
一方、人間にセンサーを装着して動作を取得するUMI型のデータは、実際のロボットを使う方法より拡張しやすく、単なる映像より正確な動作情報を得られる。人間の一人称動画はさらに大量に集められるが、手の位置や力などを映像から推定する必要があり、ノイズが多くなる。
Gopalakrishnan氏は、それぞれのデータに長所と短所があり、ハードウェアの進歩によって優劣も変わるため、現時点で一つの方式に賭けるのは早いと考えている。
ロボットAIは「作り方」そのものを競っている
世界モデルを使うのか。大規模なVLAをそのまま発展させるのか。両者を組み合わせるのか。学習データについても、teleoperation、人間動画、センサー、シミュレーションのどれを中心にするのかは、まだ決まっていない。
現在のロボットAIには、LLMにおけるTransformerのような、業界全体が収束しつつある基本設計がまだ存在しない。
Gopalakrishnan氏が語る「まだGPT-2」という表現は、単にロボットの性能が低いという意味ではない。ロボットAIはモデルの性能を競うだけでなく、どのようなモデル構造を採用し、どのデータで学習させれば汎用的な物理知能に到達できるのかという、基本設計そのものを競っている段階にある。