世界モデルにもスケーリング則はあるのか Fei-Fei Li氏が「次の視点予測」に賭ける理由


空間知能AIを開発する米World Labsが、世界モデルにも大規模言語モデル(LLM)と同じようなスケーリング則(大きくすればするほど性能が向上するという傾向)の可能性があるとして、開発を進めている。
LLMのベースとなる能力は、next token prediction、つまり「次のトークン」を予測する能力だ。計算資源を増やし、モデルを大きくし、学習データを大きくすることで、この能力が向上。ついには文章生成だけでなく、推論やプログラミングなど幅広い能力まで獲得してきた。これがLLMにおけるスケーリング則だ。
World Labsによると、同社の世界モデル「Atlas」のベースとなる能力は、「new view prediction(次の視点予測)」。「別の位置から世界がどう見えるか」を予測する能力で、計算資源などをスケールさせることで、世界モデルにも新しい能力が生まれる可能性があると言う。
共同創業者でStanford大学教授のFei-Fei Li氏は、米ベンチャーキャピタルa16zのインタビューで、「new view prediction(次の視点予測)はnext token prediction(次の視点予測)に相当する」と語った。
「次の視点」を予測する
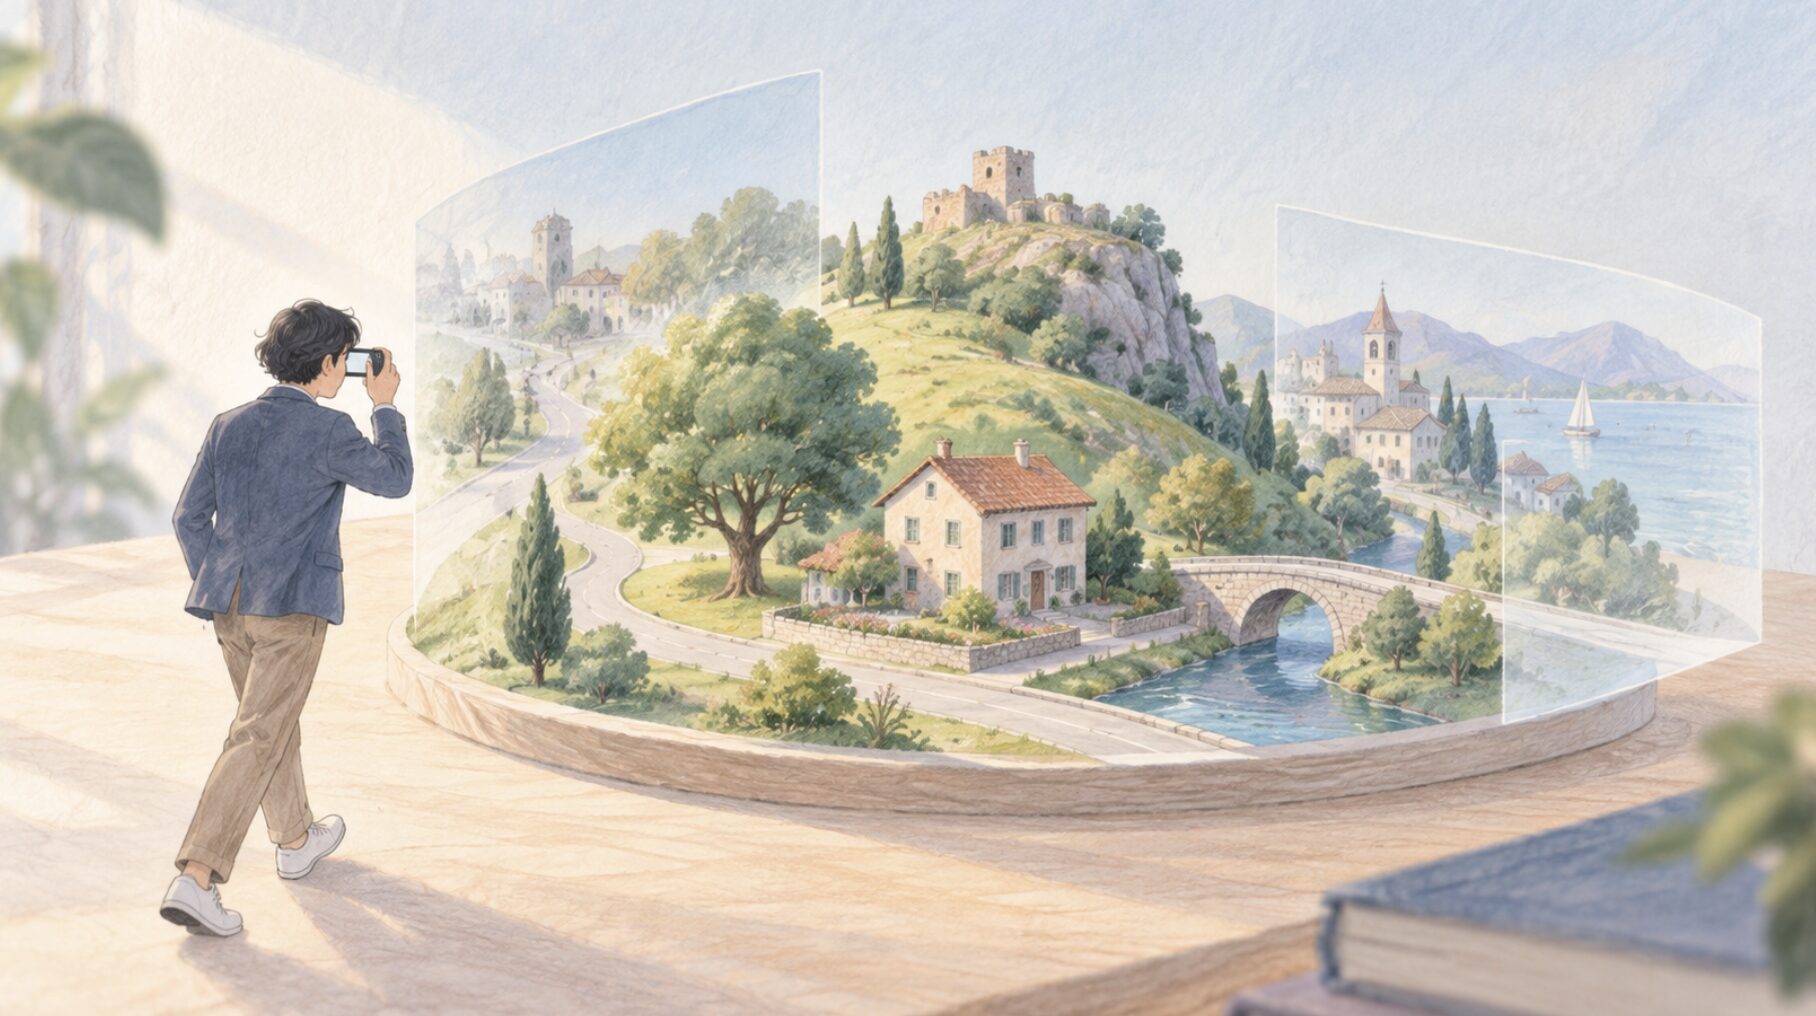
Atlasは、画像や動画から空間の構造を把握し、仮想カメラを別の位置へ動かしたとき、そこから世界がどう見えるかを予測する。
World Labsはこれを「new view prediction」と呼ぶ。
従来の動画生成AIが時間方向に「次のフレーム」を生成するのに対し、Atlasでは「この場所を別の位置や角度から見たらどう見えるか」を予測する。
そのためAtlasは、テキストや画像、動画だけでなく、カメラが3次元空間のどこにあり、どちらを向いているかという情報や、奥行きを示す深度情報まで、事前学習の段階から扱う。
この設計により、これまで別々の研究分野だった「3D再構築」と「生成」を、一つの問題として扱えるようになった。
実際に撮影された部分は空間情報をもとに再構築し、撮影されていない部分は生成能力で補う。Fei-Fei Li氏は、視点を軸に再構築と生成を統合したことをAtlasの重要な特徴として挙げている。
モデルを大きくするたびに性能が向上
World Labsが「次の視点予測」に注目する理由は、単に3D生成の精度が高いからではない。
共同創業者のJustin Johnson氏によると、Atlasの開発では、モデルを大きくし、学習時間を延ばし、より多くの半導体を使うたびに性能が大きく改善したという。
現在のアーキテクチャがそろそろ限界に達しているのかと問われると、同氏は「いや、まだ始まったばかりだ」と答えた。
今回公開したAtlasも、性能の伸びが止まったため学習を終了したわけではない。公開予定日から逆算し、その期間内に学習できる規模を選んだという。学習時間を伸ばし、モデルを大きくし、より多くの半導体を使えば、まだまだ性能が伸びそうだという。
さらにFei-Fei Li氏ら共同創業者は、会社設立当初から二つの仮説に強い確信を持っていたと語っている。
一つは、空間知能にもスケーリング則が存在するという仮説。
もう一つは、「次の視点予測」が世界モデルの学習課題の中心になるという仮説だ。
Atlasは、この二つを実際の大規模モデルで試し始めたものと位置付けられる。
性能向上は「画像がきれいになる」だけではない
ここで重要なのは、World Labsが期待しているスケーリングの効果が、生成画像の品質向上だけではないことだ。
同社は「次の視点予測」の精度を高めていくことで、空間の理解そのものが深まり、現在とは異なる能力へ広がる可能性を見ている。
「次の視点」を正確に予測するには、単に画像の見た目を覚えるだけでは足りない。
物体が空間のどこにあるのか。互いにどういう位置関係にあるのか。見えていない部分はどうなっているのか。時間が進めば何が動くのか。
予測精度を上げるほど、モデルには世界そのものについてより多くの情報を内部に持つことが求められる。
Fei-Fei Li氏は、空間知能の先には「空間を生成する」「空間内で推論する」「編集する」「相互作用する」といった能力が必要になると説明している。さらに時間軸を加えた4D、より高精度なシミュレーション、行動計画へ進むロードマップを示した。
Atlasはすでに、静止した3D空間だけに限定されたモデルではない。
前世代の「Marble」は基本的に静的な空間を扱うモデルだったが、Atlasは事前学習の段階から動きのあるデータも取り込んでいる。公開映像では水面の波や車の移動など、初期的な時間変化も確認できるという。
はい。この節は「Atlasは視覚情報でも長いコンテキストを扱える」という一点に絞った方がいいです。「2000枚→30〜40枚」は外します。
「長いコンテキスト」が世界モデルにも
World LabsがLLMとの類似性を見ているもう一つの点が、コンテキストウインドー、つまり一度に多くの情報を参照できる能力だ。
共同創業者のBen Mildenhall氏は、LLMでは長い文章や大規模なコードベースを一度に読み込ませる「長いコンテキストウインドー」の価値が広く理解されるようになった一方、画像や動画の分野では、同じ方向の研究が十分に進んでこなかったと指摘する。
同氏によると、前世代のMarbleでは、一度に扱える画像は数枚程度に限られていた。これに対しAtlasでは、64枚の画像を一つの空間的なコンテキストとして扱い、住宅全体を移動する映像を生成できるようになったという。
Mildenhall氏は、3D再構築を「非常に長いコンテキストを与えた生成」と表現する。入力画像が少なければ、モデルは見えていない部分を多く推測する必要がある。一方、多数の視点を与えれば、モデルはより多くの実際の観測情報を参照しながら、新しい視点を生成できる。
Atlasは、生成と再構築を別々の問題としてではなく、どれだけ多くの空間情報をコンテキストとして与えるかが異なる、同じ「視点予測」の問題として扱う。World Labsは、世界モデルでも一度に扱える画像や視点の量を増やすことが、能力を広げる一つの方向になるとみている。
「次の視点予測」は知能の基礎課題なのか
Johnson氏は、一見単純な予測問題でも、極限まで正確に解こうとすると、高度な知能が必要になると説明する。
同氏が例に挙げたのが、LLMの「次のトークン予測」だ。推理小説の最後が「犯人は――」で終わっている場合、次の単語を正しく予測するには、小説全体を読み、登場人物や伏線を理解し、犯人を推理しなければならない。
World Labsは、「次の視点予測」にも同じ性質があるのではないかと考えている。
別の位置から世界がどう見えるかを正確に予測するには、物体の形や位置関係だけでなく、見えていない部分や、時間とともに世界がどう変化するかまで理解する必要があるからだ。
Fei-Fei Li氏は、動物の進化を例に挙げる。動物は移動するため、少し位置を変えるだけで世界の見え方が変わる。木の陰に回り込めば、それまで見えなかったものが現れ、前に進めば物体との距離や形の見え方も変わる。こうした環境で生きるには、『次の位置から世界がどう見えるか』を予測する能力が重要だった。同氏は、この能力こそ空間知能の根本にあるのではないかと考えている。
もっとも、この能力をスケールさせることで、LLMのように幅広い新しい能力が生まれることが証明されたわけではない。現時点で確認されているのは、World Labsの開発過程で、モデル規模や学習計算量を増やすほどAtlasの性能が改善したことまでだ。
世界モデルにもLLMと同じようなスケーリングの道筋が存在するのか。World Labsは「次の視点予測」を中核に据え、Atlasでその仮説を検証しようとしているようだ。